不止朗读:英语发音评测高阶题型全解析
了解 DolphinSOE 的 11 种英语发音评测高阶题型,比较问答、话题描述、复述、背诵与自由说的评分方式、时长上限及接入参数,按场景选择合适题型。
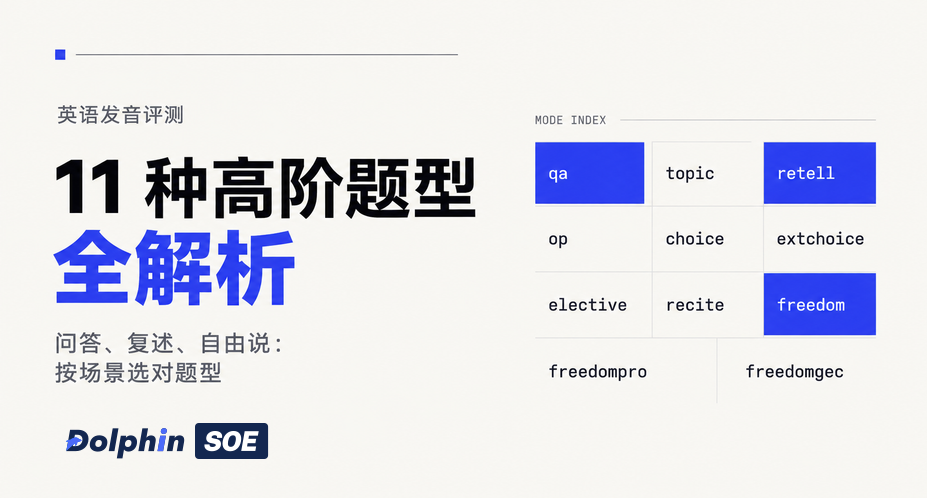
我们已经了解到,DolphinSOE 的发音评测能力包括单词、句子、段落等一系列基础题型,能够在朗读场景下进行多个维度的发音评测。但真要衡量口语能力,光会朗读远远不够。例如,围绕一个主题组织观点、根据材料进行复述,或与 AI 口语陪练自由聊天……这些场景里,用户根本没有标准答案可以照着念,基础题型无法满足需求。这时,我们就需要接入英文高阶题型。
 基础题型中的文本朗读与高阶题型中的自主表达对比
高阶题型和基础题型,区别在哪?
在之前的文章中,我们讲过了英语发音评测基础题型的相关概念,那么高阶题型又是什么呢?用一句话来概括二者的区别:基础题型是”按提示的参考文本读出来“,高阶题型是”把脑海里的内容表达出来“。
基础题型评的是发音和参考文本的贴合度——你读得是否完整、标准、流利。而高阶题型里,绝大多数都没有固定 refText,评测对象进一步提高为表达的内容本身质量如何。因此,高阶题型的题目通常具有一定复杂度,需要一定的理解、表达能力,也因此一般不面向儿童用户,也就不提供专用的儿童模型。
问答题(qa):“关键词+陷阱词”组合,既考发音又考理解
问答题解决的场景特别常见:情景问答、角色扮演、口头回答。本质是"半开放"回答,用户可以围绕关键词来进行回答。
比如有下面这道例题:
请阅读以下材料:
Surtsey was born in 1963. Scientists saw the birth of this island. It began in the morning. A fishing boat was near Iceland. The boat moved under the captain's feet. He noticed a strange smell. He saw some black smoke. A volcano was breaking out.
阅读后请回答问题:What is Surtsey?
【参考答案】
It's an island.
It's an island near Iceland.
It's an island not far from Iceland.
对于这道题,如果我们理解了阅读材料,就会知道“Surtsey”是一个岛屿的名字。这里的陷阱在第一句,我们通常习惯说“Somebody was born in ...”,因此可能有用户会理解成“Surtsey”是一个人物的名字。因此我们在设计题型参数时,除了提供参考答案,还可以编写两组词:
keyword(正确关键词):命中关键词则得分。比如这道题,可以设置关键词为island。distractorKeyword(陷阱答案):命中陷阱词,则扣分。在这道题里,我们可以设置陷阱词为scientist和captain,一旦用户脱口而出 "It's the name of a scientist",就正好落入陷阱。
对于这道题,完整的题型参数设计如下:
{
  "mode": "qa",
  "answer": [
    { "text": "It's an island." },
    { "text": "It's an island near Iceland." },
    { "text": "It's an island not far from Iceland." }
  ],
  "keyword": [
    { "text": "island" }
  ],
  "distractorKeyword": [
    { "text": "scientist|captain" }
  ]
}
系统将在判断用户回答正确与否的基础上,进一步对发音进行评分。由此,我们就可以通过一道问答题,对用户“是否理解内容”和“发音是否准确”同时进行评价。
问答题的评分维度有 overall / fluency / accuracy / integrity 等,这些分数的含义在《发音评测 API 的工作原理》这篇文章里已经介绍过,此处不再赘述。
看图说话/话题描述(topic)与口头作文(op):从“看图说话”到“雅思口语 Part 2”
这两个题型类似,但又有不同,这里对比分析一下。
topic(看图说话):提供一段文本或一组图,让用户讲出来。在这个题型里也可以传point(关键要点),但注意point只用于统计命中,不影响评分。它返回的hitPoint可以用于 UI 反馈哪些要点说到了,但分数还是按整体发音和匹配度来计算。op(oral presentation,口头作文)也是类似的场景,也可以传入point,但命中要点的数量会影响总分。
| 对比项 | topic | op |
|---|---|---|
| 要点是否计入总分 | 否(仅统计) | 是(pointWeight 默认 0.7) |
| 返回 hitPoint | 是 | 是 |
| 典型场景 | 看图说话、简单描述 | 话题描述、口头作文、雅思口语 Part 2 |
对做留学语培产品的团队来说,这两个题型可以承载围绕主题组织表达的练习。选择时,关键是确定要点命中是否需要参与评分。
复述与背诵(retell / recite):要点重现 VS 逐字复现
这两个题型考查的其实是同一件事:用户需要把听到或看到的内容尽可能地还原出来。但二者也存在些许差异。
retell(故事复述)的场景是:提供一段文本或播放一段音频,要求用户看完/听完之后复述出来。在复述过程中,考察用户的发音情况,以及对于故事情节的理解和要点重现能力。因此也提供了和topic题型一样的point参数,用于统计关键点命中情况、但不计入总分。recite(背诵)是高阶题型里唯一具有固定参考文本refText的题型,和基础题型类似。但区别在于,它支持的音频时长更长,达到 600 秒,且重点关注背诵场景下的完整度、流利度。
选择题 / 扩展选择题 / 选读题:需要用户“做选择”
在口语考试中,同样可以做“选择题”,这里考的是“理解 + 选择 + 发音”三合一。
choice(选择题):读出正确的选项内容才得分,对应的场景就是“理解问题,说出正确答案”。extchoice(扩展选择题):在choice基础上增加了关键词和陷阱词,适合“选择正确选项 + 自由扩展句式”的复合场景,比如将选出的答案补充成完整句子。elective(选读题):提供多句文本,可选择其中一句朗读,系统拿匹配度最高的那句作为评测对象,返回所选的句子序号。
如果简单考察“是否理解、是否选对”,那么用 choice 最直接。如果想在选项之外再让用户发挥扩展,那么用 extchoice。而对于“请在这几句里挑你最有把握的一句读”之类的减压式练习,则适用 elective ,降低开口门槛。
自由说 / 全开放问答 / 语法纠错:没有答案,怎么打分
在口语考试中,我们经常面对的一个题型是命题演讲。这类问题完全没有标准答案,那该怎么评分呢?这里我们对应提供三个新题型:
freedom(自由说):完全自由,没有参考文本,没有内容范围,用户想到什么说什么,关注发音准确度和流利度。freedompro(全开放问答):无参考文本的综合评测。需要提供一个主题questionPrompt,就可以评估得到relevancy(切题程度)。freedomgec(语法纠错):返回的grammar对象里带corrected(纠正后文本)、explain(解释)、type(有没有错误)。等于每句话说完,系统顺手给你改一句语法,相当于一个轻量"语法老师"。
这三个题型基本就是 AI 口语陪练类产品的能力底座。从敢说(freedom)、到说对(freedomgec)、再到说得切题(freedompro),三个层次全面覆盖。
你的场景到底该用哪个题型?
一张表看懂 11 种高阶题型怎么选:
| 题型 | 代码 | 时长上限 | 需要参考答案 | 是否考察内容命中 | 典型场景 |
|---|---|---|---|---|---|
| 问答题 | qa | 60 秒 | 是(answer) | 关键词命中 / 陷阱 | 情景问答、听选信息、角色扮演 |
| 看图说话/话题描述 | topic | 600 秒 | 是(answer) | 要点仅统计不计分 | 看图说话、口语作文 |
| 故事复述 | retell | 600 秒 | 是(answer) | 要点仅统计不计分 | 听/读后复述 |
| 口头作文 | op | 600 秒 | 是(answer) | 要点计入总分 | 话题描述、雅思口语 Part 2 |
| 选择题 | choice | 60 秒 | 是(answer) | 选项匹配 | 选择题朗读 |
| 扩展选择题 | extchoice | 60 秒 | 是(answer) | 关键词 + 陷阱 | 读选项 + 扩展回答 |
| 选读题 | elective | 60 秒 | 是(answer) | 句匹配 | 多句选读 |
| 背诵 | recite | 600 秒 | 是(refText) | 匹配度 + 韵律 | 凭记忆还原 |
| 自由说 | freedom | 600 秒 | 否 | 仅发音/流利度 | 自由发言 |
| 全开放问答 | freedompro | 600 秒 | 否(可传 questionPrompt) | 切题度 + 语法 + 词汇 | 全开放问答、口语陪练 |
| 语法纠错 | freedomgec | 600 秒 | 否 | 语法纠错 | 自由发言 + 批改 |
如果你还不确定要用哪种题型,那么可以问自己两个问题:
- 用户是在“照着念”还是在“自主表达”?
- 照着念 → 请在基础题型里寻找合适的题型
- 自主表达 → 高阶题型,继续看下一个问题
- 有没有标准答案/要点?
- 有 → 用
qa、topic、op、retell等题型 - 没有 → 用
freedom、freedompro等题型
- 有 → 用
无论是基础题型还是高阶题型,在 SDK 中都通过 mode 字段选择题型,并按所选题型配置所需参数。以 Android SDK 为例,如果使用 freedom 题型,那么使用 json.put("mode", "freedom") 就可以了。如果还有不清楚的地方,可以再回顾一下《10 分钟接入:集成发音评测 Android SDK》这篇文章。
接入 DolphinSOE
DolphinSOE 已经在日本市场稳定运行,日均调用约 10 万次(100k calls/day),客户覆盖外语学习 App、学校以及各类课外教育机构。英文高阶题型这套能力,正是支撑这些场景的产品底座。
咨询 DolphinSOE API 接入
获取免费的 API 接入技术咨询,申请一个月的无偿试用,或讨论商务合作。
分享文章
继续阅读
ASR 转写准确率:从 80% 到 98% 之间,差的不是模型,是这 4 件事
从收音设备、录音环境、录音距离和说话人因素四个维度,梳理影响 ASR 转写准确率的原因,以及热词定制、说话人分离、词级置信度与离线转写的工程用法。
10 分钟接入:集成发音评测 Android SDK
从申请测试凭证、引入 AAR、初始化 DolphinSOE,到录音或文件评测与结果回调,快速跑通 Android 发音评测 Demo。
为什么儿童英语发音评测需要专属 Kids 模型?
儿童英语发音评测为什么需要 Kids 模型?从声学差异、评分校准到 word_kids 等题型,了解 DolphinSOE 如何适配儿童语音。