
26,000 份就诊记录几乎都有编造内容:Whisper 幻觉的结构性风险与商用对策
Whisper 为什么会在静音段编造出整句话?基于 AP 调查报道与康奈尔大学研究,解析 LLM 解码器的幻觉成因、四个商用场景的代价、后处理为什么救不了,以及一份可直接执行的静音段测试清单。
TL;DR
- 幻觉有多严重:AP 调查发现约 26,000 份基于 Whisper 生成的就诊记录几乎都含编造内容;康奈尔大学研究量化:约 1% 的转写含音频中不存在的整句幻觉,38% 的幻觉内容带显性危害。
- 成因是架构性的:Whisper 的解码器本质是语言模型,遇到静音、噪音、停顿时倾向"补全最像人话的内容"。这是概率式生成的固有行为,不是能修掉的 bug。
- 解法在架构层:DolphinVoice 采用非 LLM 解码器(纯声学映射,无文本生成机制),从源头不生成幻觉——静音段直接输出空文本,医疗病历、呼叫中心质检、合规录音、无障碍字幕等场景可放心落地,详细架构见第 4 节。
- 后处理救不了:用 LLM 审核过滤幻觉等于"用幻觉查幻觉",且成本翻倍、延迟叠加。
- 验证很简单:拿含静音段的音频测——零幻觉引擎的静音段输出空文本。测试清单见第 5 节。
引言:被编造的就诊记录
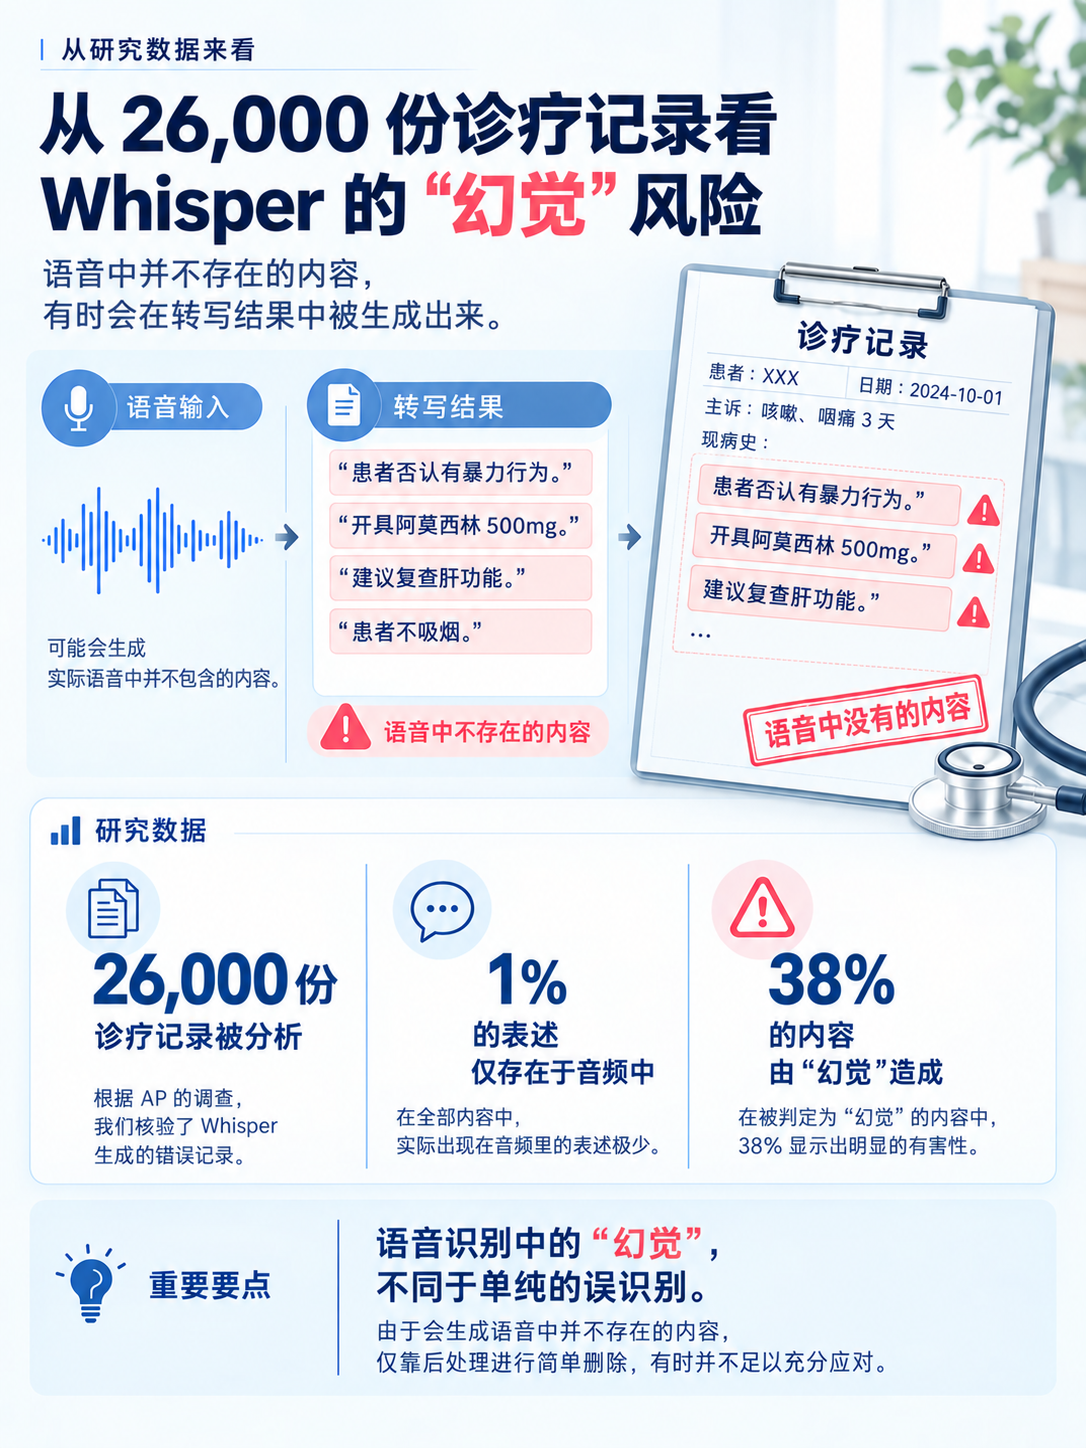
2024 年 10 月,美联社(AP)发布了一项调查报道,把语音识别行业一个心照不宣的问题摆上了台面:研究人员审查了约 26,000 份由 Nabla(一款基于 OpenAI Whisper 的医疗转写工具)生成的就诊记录,发现几乎每一份都包含音频中不存在的编造内容。这就是典型的 Whisper 幻觉(hallucination)——转写结果中出现了音频里根本不存在的文字。另一项研究在 13,000 多段发音清晰的音频片段中,也找出了 187 处幻觉。
这不是一款小众工具的事故。报道称,超过 30,000 名临床医生和 40 个卫生系统——包括明尼苏达州的 Mankato Clinic 和洛杉矶儿童医院——在使用该工具,累计转写了约 700 万次就诊记录。一位密歇根大学研究者的统计显示,其研究的转写样本中约八成存在幻觉。编造出的内容包括从未发生的药物说明、不存在的暴力言论,以及把医生和患者从未说过的内容安进记录里。
这些编造的文字,如果进入病历、进入质检报告、进入合规录音的归档,没有人会发现——因为它们"看起来完全像人话"。
这不是一个 bug,而是一个架构问题。 本文想讲清楚三件事:Whisper 为什么会编造、这在商用场景里意味着什么代价、以及你作为技术决策者,如何验证一个转写引擎到底会不会幻觉。
1. Whisper 为什么会"编造"——LLM 解码器的结构性风险
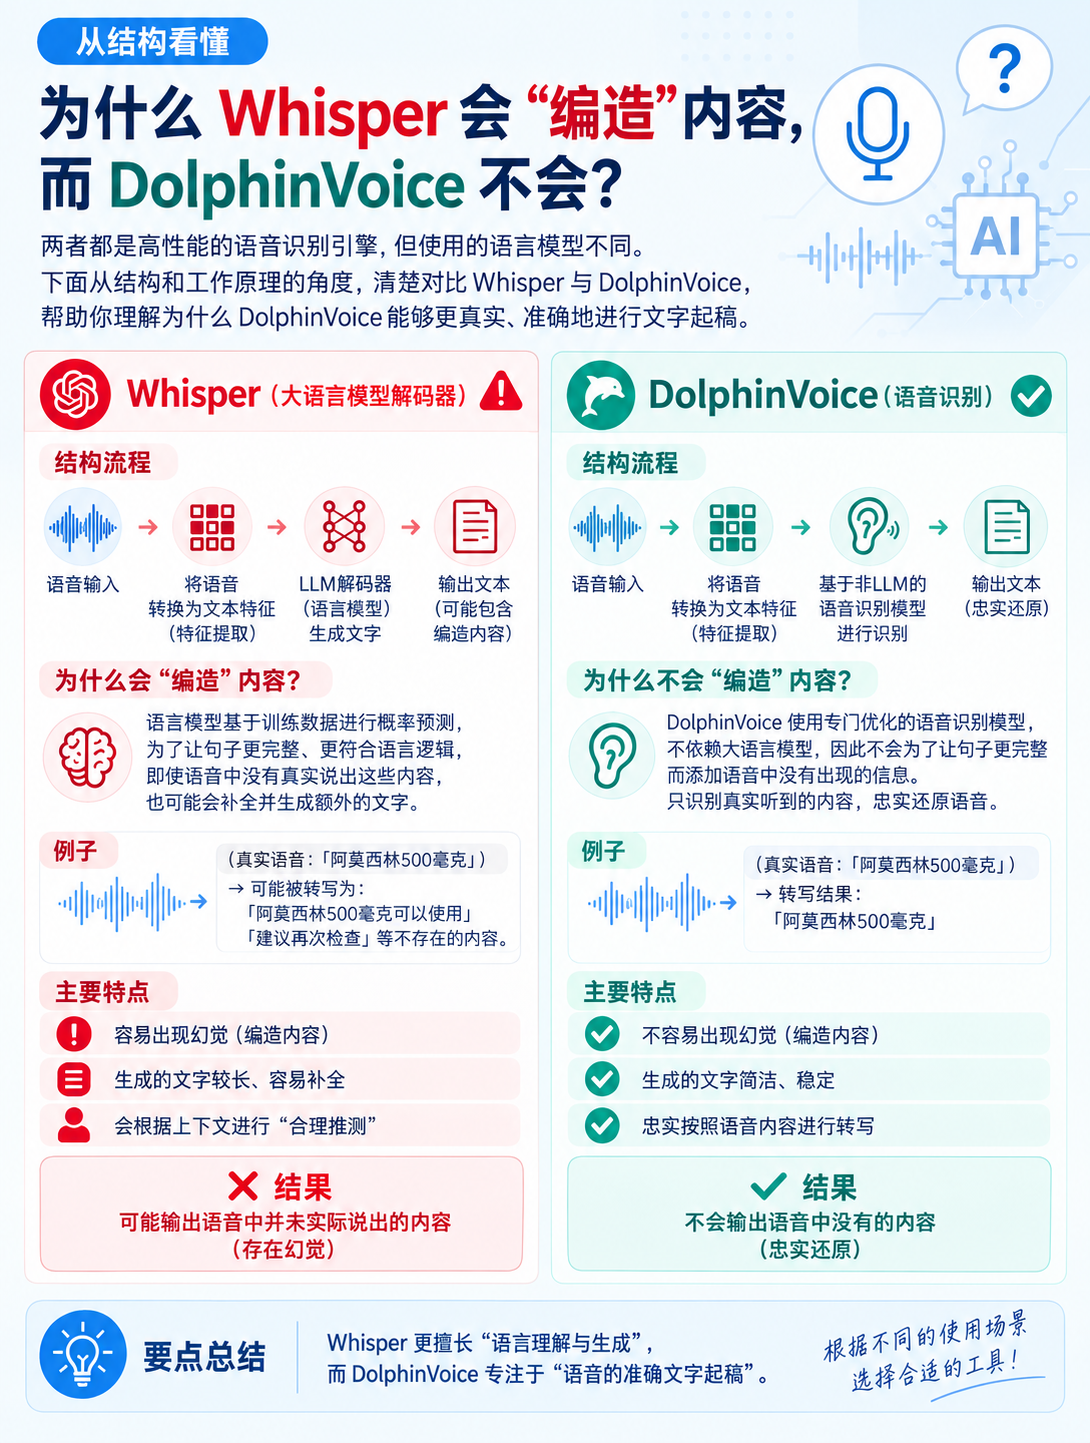
先说结论:Whisper 的幻觉,来自它的解码器本质上是一个语言模型。
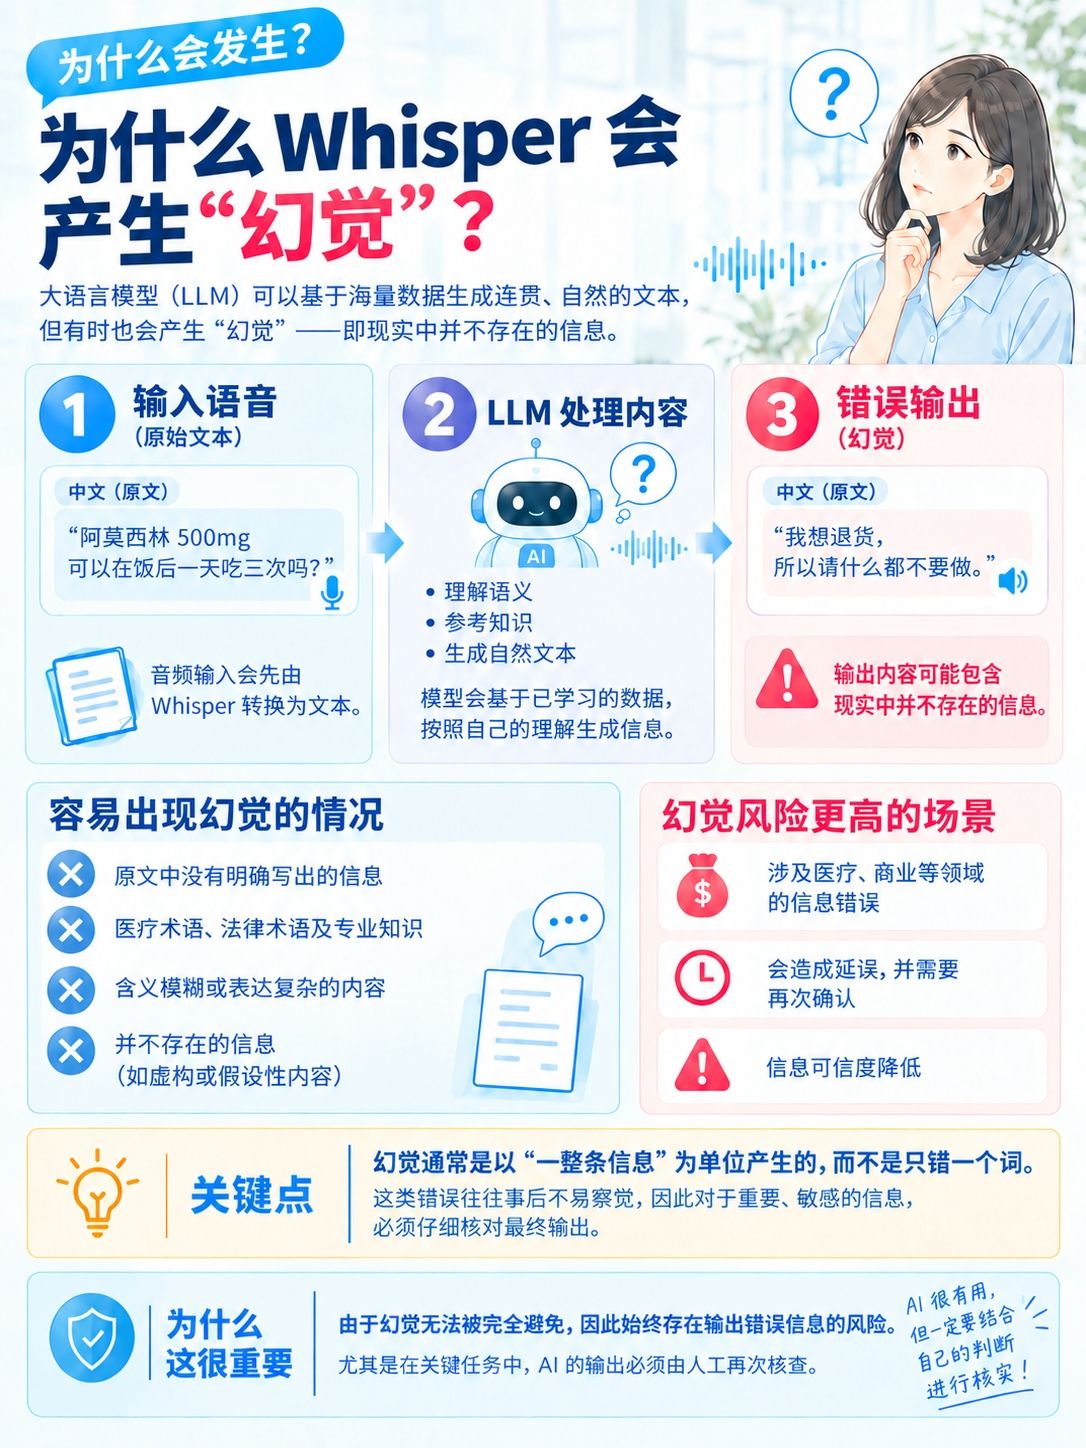
Whisper 的架构分为两部分:编码器负责把音频变成声学特征,解码器则负责把这些特征"翻译"成文字。关键在于,这个解码器是一个自回归的语言模型——它在训练时学习了海量"文本接龙"的能力,生成文字时,每一步都在预测"接下来最可能出现什么词"。
这个设计在清晰语音上效果很好,Whisper 的识别准确率在业界有口皆碑,学术论文也明确承认这一点。但问题出在音频没有有效语音的时候:遇到静音段、长时间停顿、背景噪音、咳嗽声,一个纯声学系统的正确行为应该是"输出空文本"——这里没有话。而一个语言模型的训练惯性是**"补全最像人话的内容"**——它见过太多"接下来通常会说这句话"的语料,于是在该闭嘴的时候,它开口了。
工程界普遍认为静音段和背景噪音是幻觉的重要诱因,但坦率地说,确切成因至今没有被完全定位。这不是某个版本修一修就能解决的缺陷,而是概率式语言生成与生俱来的行为模式。
已量化的证据
康奈尔大学的研究 "Careless Whisper: Speech-to-Text Hallucination Harms"(Koenecke 等,arXiv:2402.08021)给出了目前最有参考价值的量化数据:
- 约 1% 的转写包含音频中完全不存在的整句幻觉——注意,是整句,不是个别词的识别错误;
- 38% 的幻觉内容包含显性危害:暴力言论、虚假关联(比如把不同人的发言捏合成一句话)、捏造的权威表述;
- 非发声时长较长的说话者,幻觉率显著更高。研究特别指出,失语症患者等有言语障碍的人群是重灾区——恰恰是最需要转写辅助的群体,承受最高的编造风险。
OpenAI 自己的立场也印证了问题的严重性:Whisper 的使用政策禁止将其用于高风险决策场景,开源模型卡中建议不要在高风险领域使用。但现实是,大量医疗机构仍在把它接进关键流程。 日本的 ITmedia 等主流科技媒体也对这一问题做过报道——如果你在日企负责选型,这个问题值得摆上桌面。
关键洞察:幻觉是"最可信"的错误
这里有一个容易被低估的事实:幻觉不是随机错误,而是模型在"最像人话"的方向上出错。 识别错误往往是明显的乱码、错字,一眼就能看出来;而幻觉生成的是语法通顺、语义合理、语气自然的完整句子——它看起来格外可信,所以危害也格外大。下游的审核者、检索系统、LLM 分析管线,都默认"转写文本是可信的原始记录"。幻觉恰恰利用了这个信任。
2. 商用场景里的幻觉代价:医疗、呼叫中心、金融与无障碍字幕
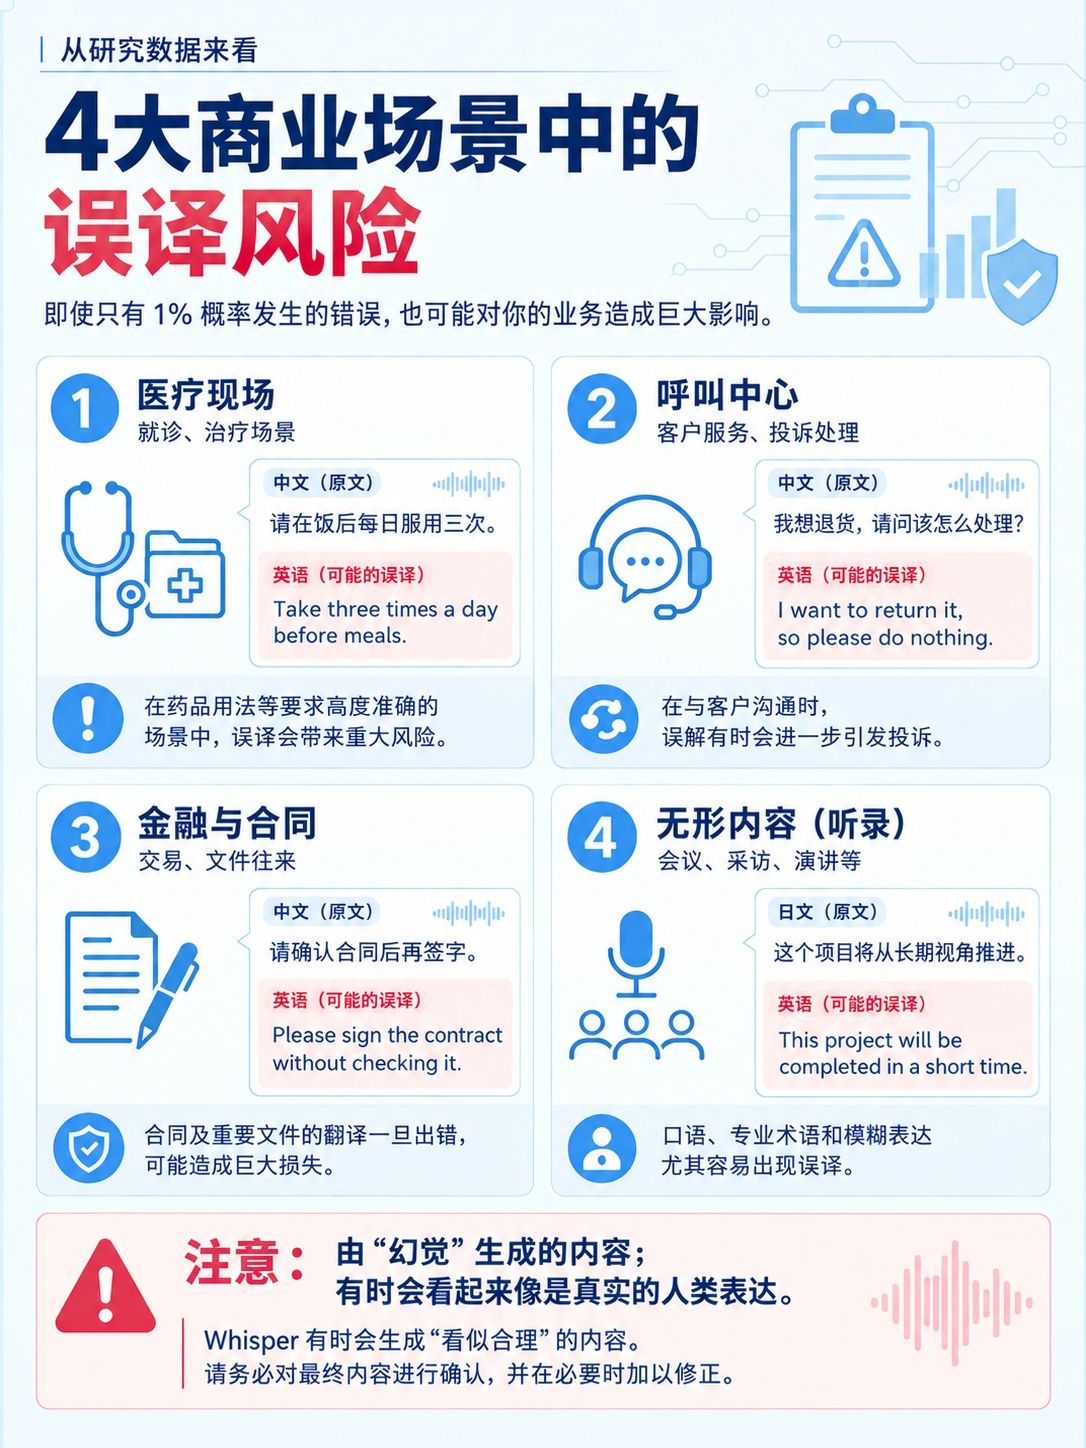
抽象地讨论"1% 的幻觉率"没有意义,关键是它在你的业务里变成什么。
| 场景 | 幻觉的可能形态 | 业务后果 |
|---|---|---|
| 医疗就诊记录 | 编造不存在的医嘱、药物说明、患者陈述 | 误导后续诊疗,医疗事故与法律风险(AP 报道中 Mankato Clinic 等机构均受波及) |
| 呼叫中心质检/合规 | 静音段或噪音段被补全成"客户原话" | 编造内容被当作真实对话进入质检报告、培训教材,扭曲客诉归因 |
| 金融录音合规 | 交易确认环节的停顿被"补全"成承诺性语句 | 监管要求的忠实记录出现编造,构成合规事故而非技术瑕疵 |
| 听障人士字幕 | 无语音段落出现字幕文本 | 用户完全没有能力识别哪些是编造的——这是无障碍场景里最不对称的风险 |
第四个场景值得单独强调:Whisper 被广泛用于为听障人士生成字幕。听力健全的人看字幕时可以对照音频发现"这段没人在说话",而听障用户做不到——他们收到的每一段编造文字,都是他们无法核验的"事实"。
呼叫中心场景再展开一句:客服对话里有大量静音(客户思考、查询、背景噪音),这恰恰是幻觉的高发区。如果质检系统的训练数据、坐席的培训材料里混入了编造的"客户原话",你基于错误数据做的每一个运营决策,都会被系统性带偏——而且没人知道源头错了。
3. 为什么"后处理过滤"救不了幻觉
很多团队的第一反应是:接一个 LLM 在转写结果后面做审核,把幻觉过滤掉。这条路走不通,原因有三层:
- 用幻觉查幻觉。 审核 LLM 本身就是语言模型,它同样有幻觉问题。更糟的是,它面对一段"语法通顺、语义合理"的幻觉文本时,没有任何音频原始内容(ground truth)可以比对——它判断不了这句话有没有被说过,只能判断这句话"像不像人话"。而幻觉恰恰就是"最像人话"的。
- 成本翻倍。 每小时音频的转写成本之外,再叠加一次 LLM 调用的 token 成本。对于日均处理上千小时音频的业务,这是直接翻倍的推理账单。
- 延迟叠加。 实时场景(如客服实时质检、实时字幕)需要低延迟,串接一个 LLM 审核环节会显著拉长链路。
结论:幻觉必须在解码器层面解决,不能靠下游修补。 这是一个架构问题,就只能用架构答案回应。这也是 DolphinVoice 在设计之初就选择非 LLM 解码器路线的原因——不是我们更擅长过滤幻觉,而是我们从源头上不生成幻觉。
4. 零幻觉架构:从源头不编造
DolphinVoice 的转写引擎采用纯声学模型架构,不使用 LLM 解码器。两者在幻觉问题上的本质区别如下:
| LLM 解码器(如 Whisper) | 声学解码器(DolphinVoice) | |
|---|---|---|
| 生成逻辑 | 基于语言模型概率,预测"最可能的文字" | 基于声学特征对齐,音频里有什么才输出什么 |
| 遇到静音段 | 训练惯性倾向"补全"合理文本 | 输出空文本——没有语音,就没有文字 |
| 幻觉的来源 | 结构性存在,只能缓解 | 架构上不存在生成路径 |
| 适合的位置 | 清晰音频的非关键场景 | 对"忠实"有硬要求的商用场景 |
零幻觉在这里的含义很具体:音频里没有的语音,不会出现在输出里;静音段输出空文本。 这是架构性质,不依赖任何后处理兜底。
这不是说我们只解决了幻觉就万事大吉。作为商用引擎,DolphinVoice 目前承载日均 15,000+ 小时的处理量;在 8kHz 呼叫中心音频上 WER 约 5%;实时首字延迟约 1 秒,离线转写约 58 秒/小时音频(含语者分离);实时语者分离、热词定制、ITN、语气词与敏感词过滤都是内置能力——接口细节可在开发者文档查阅,价格见 API 价格页。值得一提的是 CPU 推理架构——1 核对应 1 路并发,无需 GPU——这让零幻觉能力在私有化部署时也能完整落地,不必迁就云端 GPU 的供给。
5. 选型时如何验证"零幻觉"——给买家的测试清单
无论你最终选谁,我们都建议在 POC 阶段把幻觉测试写进验收标准。方法很简单,不需要任何特殊设备:
第一步,准备四类"困难音频",每类 10 条左右:
- 纯静音段(含 3 秒以上的连续静音夹在两句正常语音之间);
- 白噪音/粉噪音背景下的短语音;
- 非语音人声:咳嗽、清嗓子、笑声、"ええと…"之类的长时间填充词;
- 非典型语速与长停顿:刻意放慢的语速、句间停顿 5 秒以上的独白。
第二步,转写并统计:静音段和噪音段的位置,是否出现了任何文本输出。 这一步可以人工对照波形图完成,也可以让供应商提供带时间戳的输出逐段核对。
第三步,检查输出的时间戳对齐性。 零幻觉引擎的文本时间戳应该严格落在有效语音区间内;如果一个时间戳区间内没有可闻语音却挂着文本,那就是幻觉。
判读标准建议:不是"幻觉率低于 X%",而是"静音段是否输出空文本"——前者可以靠运气和样本偏倚美化,后者是架构行为,测出来是什么就是什么。
这套测试对任何供应商都适用,包括我们。一个对自身架构有信心的供应商,应该欢迎你拿着静音段音频来测。你也可以直接在 DolphinVoice Playground 上传一段含静音区的音频——实时与离线两种模式都能立即看到静音段的输出行为。
结论
一句话收束全文:Whisper 的幻觉是 LLM 解码器的结构性风险——约 1% 的转写含整句幻觉、38% 的幻觉带显性危害,后处理救不了,只能靠架构解决。 验证方法同样一句话:拿含静音段的音频测,零幻觉引擎的静音段输出空文本。
结语:转写工具的第一职责是"忠实"
回到开头的 26,000 份就诊记录。语音识别工具的第一职责是忠实记录,在这条底线上,编造比漏识别危险得多——漏识别是能力的上限问题,编造是可信度的归零问题。一个会往你的质检报告、合规录音、医疗记录里掺入"看起来完全像真话"的假内容的系统,准确率再高也不该出现在关键链路里。
如果你正在评估或已经在使用 Whisper 类方案,建议先跑一遍第 5 节的自测清单,看看自己的静音段音频会被转写成什么。可以直接在 Playground 上传音频体验,或通过快速注册入口接入测试。
我们(DolphinVoice 团队)也可以为你提供一组用于幻觉自测的静音段/噪音段音频样本,欢迎联系我们获取测试方案。
常见问题(FAQ)
什么是 Whisper 幻觉(hallucination)?
转写结果中出现音频里根本不存在的文字。典型形态:静音段、噪音段、咳嗽或长停顿被"补全"成语法通顺的完整句子。AP 调查的约 26,000 份基于 Whisper 的就诊记录中,几乎每一份都包含这类编造内容。
Whisper 幻觉在什么情况下最容易发生?
音频中没有有效语音的时候:连续静音、背景噪音、非语音人声(咳嗽/笑声/填充词)、长停顿。此时纯声学系统应输出空文本,而 LLM 解码器会按语言模型惯性"补全最像人话的内容"。
能用 LLM 后处理把幻觉过滤掉吗?
不可靠。审核 LLM 本身就是语言模型——用幻觉查幻觉;且它没有音频原始内容可比对,只能判断文本"像不像人话",而幻觉恰恰最像人话。同时带来成本翻倍与延迟叠加。幻觉必须在解码器层面解决。
如何测试一个转写引擎会不会幻觉?
准备四类困难音频(纯静音段、噪音背景短语音、咳嗽笑声等非语音人声、慢语速长停顿),转写后检查静音段与噪音段位置是否出现任何文本输出。判读标准不是"幻觉率低于 X%",而是"静音段是否输出空文本"——后者是架构行为,无法靠样本美化。
DolphinVoice 为什么不会有这类幻觉?
DolphinVoice 采用纯声学模型架构,不使用 LLM 解码器:音频里有什么才输出什么,静音段输出空文本。这是架构性质,不依赖后处理兜底。引擎目前在日本实际商用落地日均15,000+小时,涵盖呼叫中心会议纪要等多个行业,经受了实际应用场景的高并发和高识别率要求。
数据出处
- AP 调查报道(2024 年 10 月):Nabla 基于 Whisper 的就诊记录审查,约 26,000 份
- 康奈尔大学研究 "Careless Whisper: Speech-to-Text Hallucination Harms"(Koenecke 等):arXiv:2402.08021
- OpenAI Whisper 使用政策与开源模型卡中的高风险场景使用限制
- DolphinVoice 性能数据:dolphinvoice.ai 官网(2026 年 8 月)
分享文章
继续阅读
为什么儿童英语发音评测需要专属 Kids 模型?
儿童英语发音评测为什么需要 Kids 模型?从声学差异、评分校准到 word_kids 等题型,了解 DolphinSOE 如何适配儿童语音。
从音标到段落,一次讲清英语发音评测基础题型
DolphinSOE 英语发音评测该如何选择 phoneme、word、sentence、chapter、wordcheck 等基础题型?本文按评测粒度、时长和纠错能力逐一说明。
发音评测 API 的工作原理:从音频到多维度打分
一段朗读音频提交后,发音评测 API 如何给出总分、准确度、流利度等多维评分?本文拆解 DolphinSOE 从音频采集、识别对齐到多维度打分的完整流程,并附真实返回示例。