
为什么儿童英语发音评测需要专属 Kids 模型?
儿童英语发音评测为什么需要 Kids 模型?从声学差异、评分校准到 word_kids 等题型,了解 DolphinSOE 如何适配儿童语音。
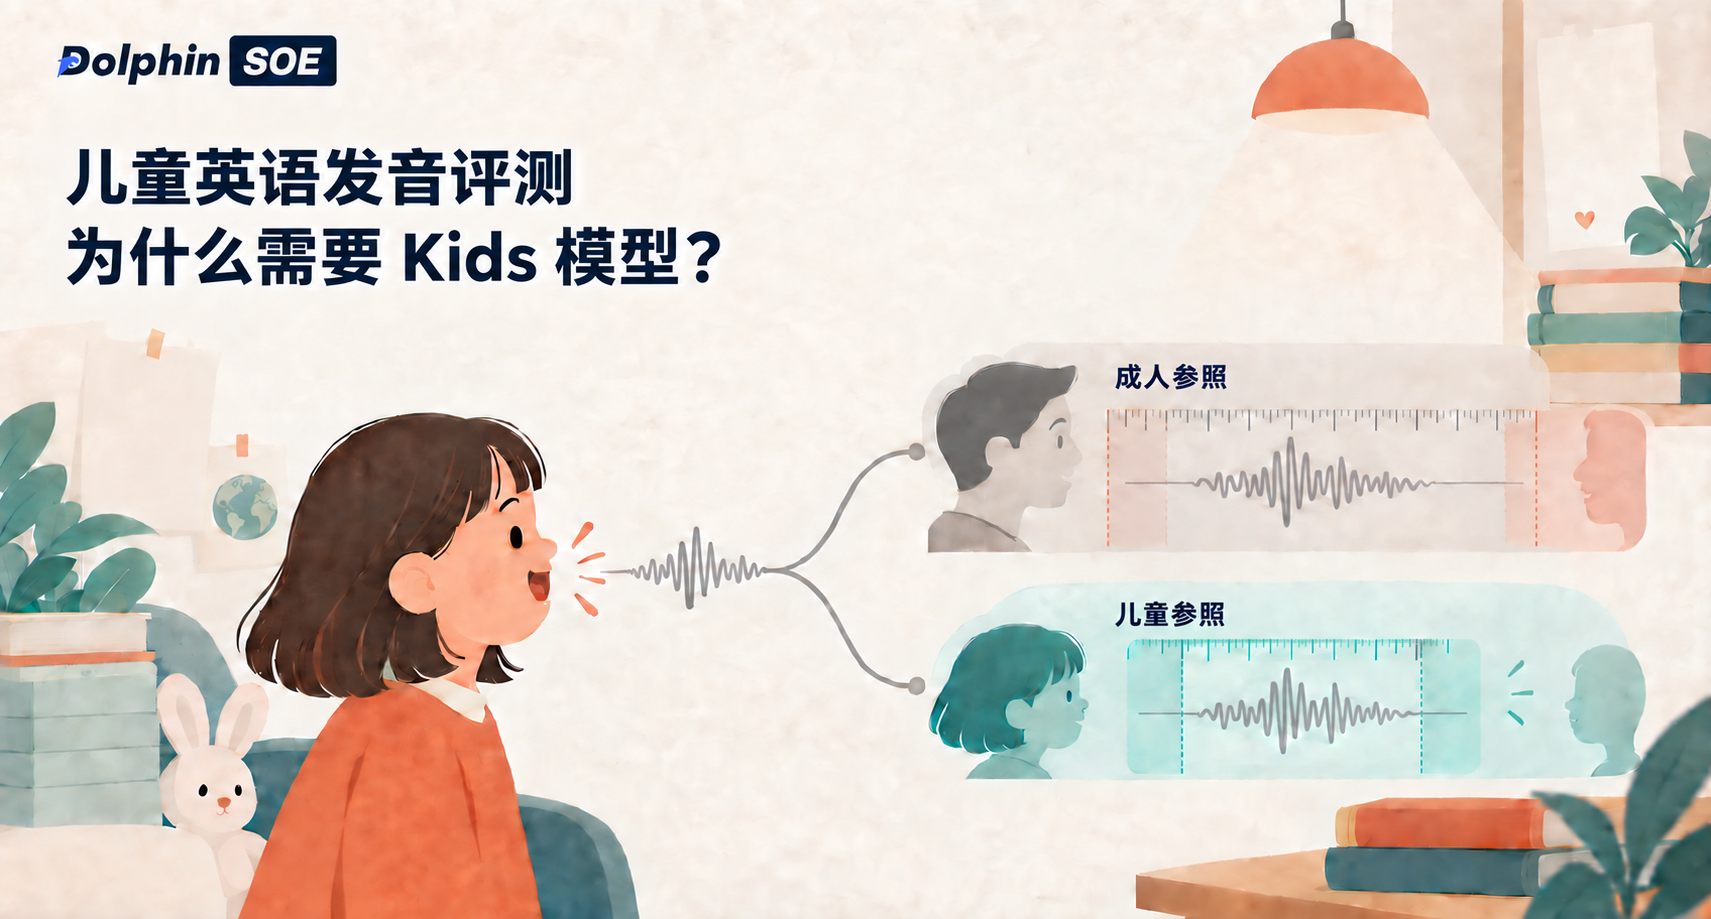
让一个 7 岁的孩子去投 3.05 米的标准篮筐,他很可能投不进。但这未必说明他不会投篮。篮筐是按成人身高定的,把篮筐降到儿童适宜的高度,我们才能看出他的真实水平和进步的曲线。
 站在高高的篮球架下的孩子和篮球。
儿童英语发音评测面临的是同样的问题。绝大多数口语评测引擎的声学模型是在大规模的成人语音数据基础上训练的,用它给孩子打分,得到的分数自然也不可靠。但发音评测是否像篮筐一样,只是降低高度(评分标准)就可以了?答案并不是这样简单。
在前一篇文章:从音标到段落,一次讲清英语发音评测基础题型 里我们提到过,选型时要关注的一个问题是“用户是成人还是儿童”。本篇文章将就这个问题展开,了解儿童发音评测模型到底解决了什么。
儿童语音到底"特殊"在哪?
儿童并不是“英语发音不到位的成人”,儿童语音在基频、共振峰、语速和发音稳定度上都与成人存在系统性差异,他们的语音特征在物理层面根本就是另一套数据分布。
| 层面 | 儿童的实际情况 | 对通用模型的冲击 |
|---|---|---|
| 基频 F0 | 学龄儿童普遍在 250–400 Hz,明显高于成年男性(约 120 Hz)、成年女性(约 200 Hz)[1] | 声学模型帧级后验概率整体偏低 |
| 声道长度 | 声道短,共振峰频率近似按声道长度比例整体上移 [1] | 元音空间整体偏移,元音识别偏差 |
| 发音器官 | 尚未发育完全,/r/↔/w/、/θ/↔/s/、/l/↔/r/ 等音标发音不稳定 [2] | 被判定 replace(错读) |
| 语流节奏 | 停顿多、拖长音、气息弱、音量忽大忽小,语速慢于成人 [3] | fluency / integrity 失分 |
 不同年龄人群的第一、第三共振峰在不同舌位元音上的分布图 [1]
从上图可以看出,不同年龄段的群体,在相同的元音上的共振峰分布具有明显的差异。通用模型的问题在于:它只在成人语音上见过这些参数的分布范围,一旦输入整体偏移,模型对“这个音素发得对不对”的置信度就会普遍下降——这也是儿童语音识别准确率长期低于成人的根本原因。
通用模型在儿童语音上会犯哪些错误?
由于上述差异,如果将通用模型用于儿童发音评测场景,通常会造成以下问题:
一、系统性压分。 声学不匹配导致音素后验概率整体偏低,accuracy (准确度)就会下降。麻烦的是这个低分与孩子的真实发音水平无关,孩子练得再努力,分数也提高不上去。
二、误判错读。 发育性的发音偏差被标成 replace (错读)类型,App 高亮提示“这个词读错了”,可孩子其实读对了。长此以往,孩子的信心必然受挫。
三、流利度误伤。 用成人的语速基准去衡量儿童,fluency 会长期偏低。而流利度恰恰是儿童最不该被苛责的维度——磕磕绊绊是正常的学习过程。
所以通用模型的问题不是“打分严格”,而是打分不准:它衡量的不是孩子真实的发音水平,而是孩子的发音离成人水平有多远,但这并不是我们想要的结果。
对儿童产品来说,这就不只是打分精度问题了,它会形成一个恶性闭环:
 分数偏低、孩子受挫、练习减少与能力提升减缓形成的循环。
如此反复,用户就流失了。以单词题型为例,同一段儿童音频,两个模型的典型表现差异如下:
| 维度 | word(通用) | word_kids(儿童) | 差异原因 |
|---|---|---|---|
| overall | 62 左右 | 85 左右 | 声学模型与评分曲线不同 |
| accuracy | 明显偏低 | 回到合理区间 | 音素后验概率校准 |
| 词级别 type | 易出现 replace | 多为 normal | 发育性偏差不再判为错读 |
| 音素级反馈 | 有 | 有 | 粒度一致,不受影响 |
Kids 模型到底是什么?
Kids 模型是以儿童语音语料调优的专用声学模型,配合针对儿童发音分布校准的评分策略。
它对应三个题型代码,与通用题型一一对应:
| 儿童题型 | 对应通用题型 | 时长上限 | 大小上限 |
|---|---|---|---|
| word_kids | word | 20 秒 | 1 MB |
| sentence_kids | sentence | 90 秒 | 1.5 MB |
| chapter_kids | chapter | 300 秒 | 10 MB |
除了模型不同,题型限制、参考文本上限、考察维度、返回结构都与通用版完全一致。
更准确地说,儿童模型改变的是评分的参照系——从“与成人标准发音比”,改成“与同龄儿童的发音分布比”。它不是简单把分数整体抬高,而是把分数放回一个公平的基准上,让分数在孩子之间可比、在同一个人身上跨时间可比。
从 word 迁移到 word_kids,你需要改的只是一个请求参数 mode。
引擎侧做了哪些儿童适配?
如果你已经读过先前的 发音评测 API 的工作原理 这篇文章,可以把它理解为同一条流水线上的儿童分支。
声学模型。 底层的双头 LSTM 结构不变——多层 LSTM 输入 fbank 特征,后面接文本和音素两个输出分支,一次前向同时产出文本与音素对齐。儿童版本的区别在于训练语料:用儿童朗读语音训练/自适应,覆盖不同年龄段、口音和录音设备。这一步直接决定了音素后验概率在儿童音频上还能不能用。
评分校准。 对齐之后,评分曲线按儿童发音的分布重新校准,消除“整体偏低”的系统性偏差。可以理解为把尺子的零点挪到了正确的位置。
儿童场景的合规问题
在儿童使用场景中,另一个重要问题就是合规性,未成年人的数据隐私需要得到特殊保护。
DolphinSOE 已通过多项信息安全相关认证,包括 ISO 27001 信息安全管理体系认证,并取得 SOC 2 Type II 认证报告。数据全程通过 HTTPS/WSS 加密传输,云端数据存储在位于东京的数据中心,保证做到数据不出境。
数据采集范围遵循最小必要原则,SDK 侧不采集个人身份信息,只有语音、评测文本会传输到引擎侧;所有音频默认不在引擎侧保存;在用户需要下载音频的场景中,通过参数设置可临时在引擎侧保存 30 天,到期后将自动销毁。数据不出售、不出租给任何第三方。
DolphinSOE 发音评测已在日本市场稳定运行,目前日均调用量约 10 万次(100k calls/day),客户覆盖外语学习 App、学校、课外班等各类教育机构,能力经过真实高并发、教学级场景的持续验证,合规性得到教育行业标杆客户认可。
用同一段录音比较两种模型
如果你正在做面向儿童的产品,你应该先分析对比一下当前的效果。用一段真实的儿童录音,用通用模型和儿童模型分别测试一遍,看看分数差异。差距最大的评分指标,往往就是通用模型一直在误判的地方。用成人口语料训练的通用声学模型对儿童的语音去打分,会把儿童的发育特征当成发音错误,分数因此被整体压低。儿童模型做的事情,就是把评分的参照系从“成人标准”换回“儿童的发音分布”。
参考文献
[1] Vorperian, H. K., & Kent, R. D. (2007). Vowel acoustic space development in children: A synthesis of acoustic and anatomic data. Journal of Speech, Language, and Hearing Research, 50(6), 1510-1545.
[2] Preston, J. L., & Lee, S. (2025). The articulatory basis of phonological error patterns in childhood speech sound disorders. Frontiers in Human Neuroscience, 19, 1635096.
[3] Logan, K. J., Byrd, C. T., Mazzocchi, E. M., & Gillam, R. B. (2011). Speaking rate characteristics of elementary-school-aged children who do and do not stutter. Journal of Communication Disorders, 44(1), 130–147.
分享文章
继续阅读
26,000 份就诊记录几乎都有编造内容:Whisper 幻觉的结构性风险与商用对策
Whisper 为什么会在静音段编造出整句话?基于 AP 调查报道与康奈尔大学研究,解析 LLM 解码器的幻觉成因、四个商用场景的代价、后处理为什么救不了,以及一份可直接执行的静音段测试清单。
从音标到段落,一次讲清英语发音评测基础题型
DolphinSOE 英语发音评测该如何选择 phoneme、word、sentence、chapter、wordcheck 等基础题型?本文按评测粒度、时长和纠错能力逐一说明。
发音评测 API 的工作原理:从音频到多维度打分
一段朗读音频提交后,发音评测 API 如何给出总分、准确度、流利度等多维评分?本文拆解 DolphinSOE 从音频采集、识别对齐到多维度打分的完整流程,并附真实返回示例。