DocumentLensの紹介
DocumentLensは、TurboLensが開発したAI駆動型ドキュメントインテリジェンススイートであり、東南アジア地域で頻繁に使用される文書の処理、分析、検証を目的として設計されています。ベトナムの請求書、フィリピンのBIRフォーム、タイ語の領収書、タガログ語のKYC文書など、地域特有の書式、多言語対応、文化的な文脈による課題に対応します。銀行、保険、法務、医療、物流などの分野で大量の構造化・非構造化文書を扱うチームを対象としています。
汎用的なグローバル文書AIツールとは異なり、DocumentLensは数千点の地域固有文書から得た学習データに基づき、ゼロから構築されています。そのモデルは言語的ニュアンス、レイアウトの複雑さ、地域の規制要件を統合しており、標準的なOCRおよびNLPシステムでは捉えきれない文脈的理解を実現します。クラウドベースのワークフローおよびエンタープライズ向けAPI連携に対応し、セキュリティとスケーラビリティを基本設計原則としています。
主なポイント
- スキャンされた文書における画像レベルの改ざん・偽造を検出し、改ざん確率スコアおよびヒートマップ形式での可視化を提供
- 2つの文書バージョン(例:契約書の草案と最終版)を比較して挿入・削除・変更を高精度に検出し、複数言語混在や複雑なレイアウトにも対応
- 東南アジアの文書構造(地域固有の命名規則、フォーム項目、スタンプ、透かし)に最適化されたスキーマ指向型、文脈認識型データ抽出機能
- ベトナム語、タイ語、インドネシア語(バハサ)、タガログ語、マレー語、ヒンディー語など、地域言語に対する本格的なOCR対応。文化的文脈と書式規則を考慮した正確な認識を実現
- 表、グラフ、チェックボックス、マルチカラムレイアウト、公的印鑑などから構造化データを高精度で抽出
- 透かしや背景ノイズを自動除去し、後続の抽出精度を向上
- 大規模な文書処理を可能とする、セキュアでスケーラブルなエンタープライズAPIを備え、企業システムとの統合を支援
DocumentLensの仕組み
DocumentLensは、文書抽出、バージョン比較、画像偽造検出、文書解析の4つの主要機能モジュールから構成されます。ユーザーはまずPDF、JPG、PNG形式の文書をアップロードし、主言語を選択し、必要に応じてカスタムスキーマを指定して対象フィールドを定義します。その後、言語固有のOCR技術に加え、レイアウト理解および意味モデリングを適用し、キー・バリューペア、構造化レコード、フィールド間の文脈的関係を抽出します。
バージョン比較では、ユーザーが2つの文書(例:契約書の下書きと確定版)をアップロードすると、AIが単なる文字列一致ではなく、意味的整合性に基づいて内容を照合し、異なる言語やフォーマット間でも変更を正確に特定します。偽造検出機能は、ピクセルレベルの不整合、照明の異常、コピー&ペーストによる改ざん痕跡を画像上で分析し、定量的なリスクスコアと領域ごとのヒートマップを出力します。すべてのワークフローは「アップロード → 設定(言語/スキーマ/パラメータ) → 構造化結果または差分表示の確認」という一貫した3ステップで構成されます。
主な利点と用途
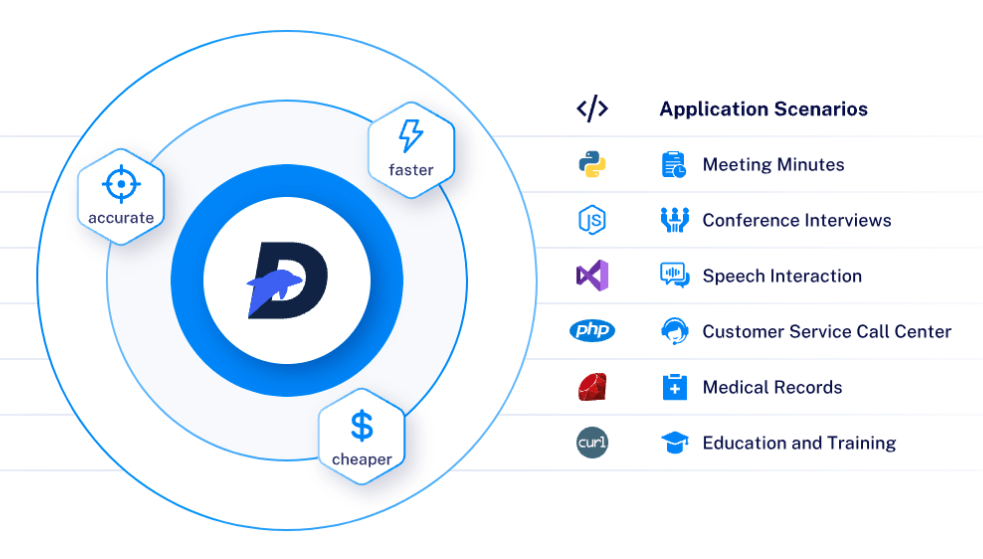
DocumentLensは、東南アジア全域の規制対応型かつ文書依存度の高い業界において、具体的な価値を提供します。金融機関では、偽造身分証明書の検出や、地域の銀行明細書・納税書類からのデータ抽出により、KYCプロセスを高速化します。保険会社は、提出された領収書の妥当性検証や、修正された保険契約書の比較を通じて、請求処理を自動化します。法務チームは、契約書の改訂箇所を正確に特定することで、手作業によるレビュー時間を大幅に削減できます。医療機関は、地域の用語や書式を維持したまま患者記録をデジタル化します。物流企業は、多言語対応の船荷証券や通関書類の自動処理を実現します。これらのすべてのユースケースにおいて、DocumentLensはルールベースのテンプレートへの依存を低減し、追加のファインチューニングを必要とせずに高い精度を実現します。