Lipsync AIの紹介
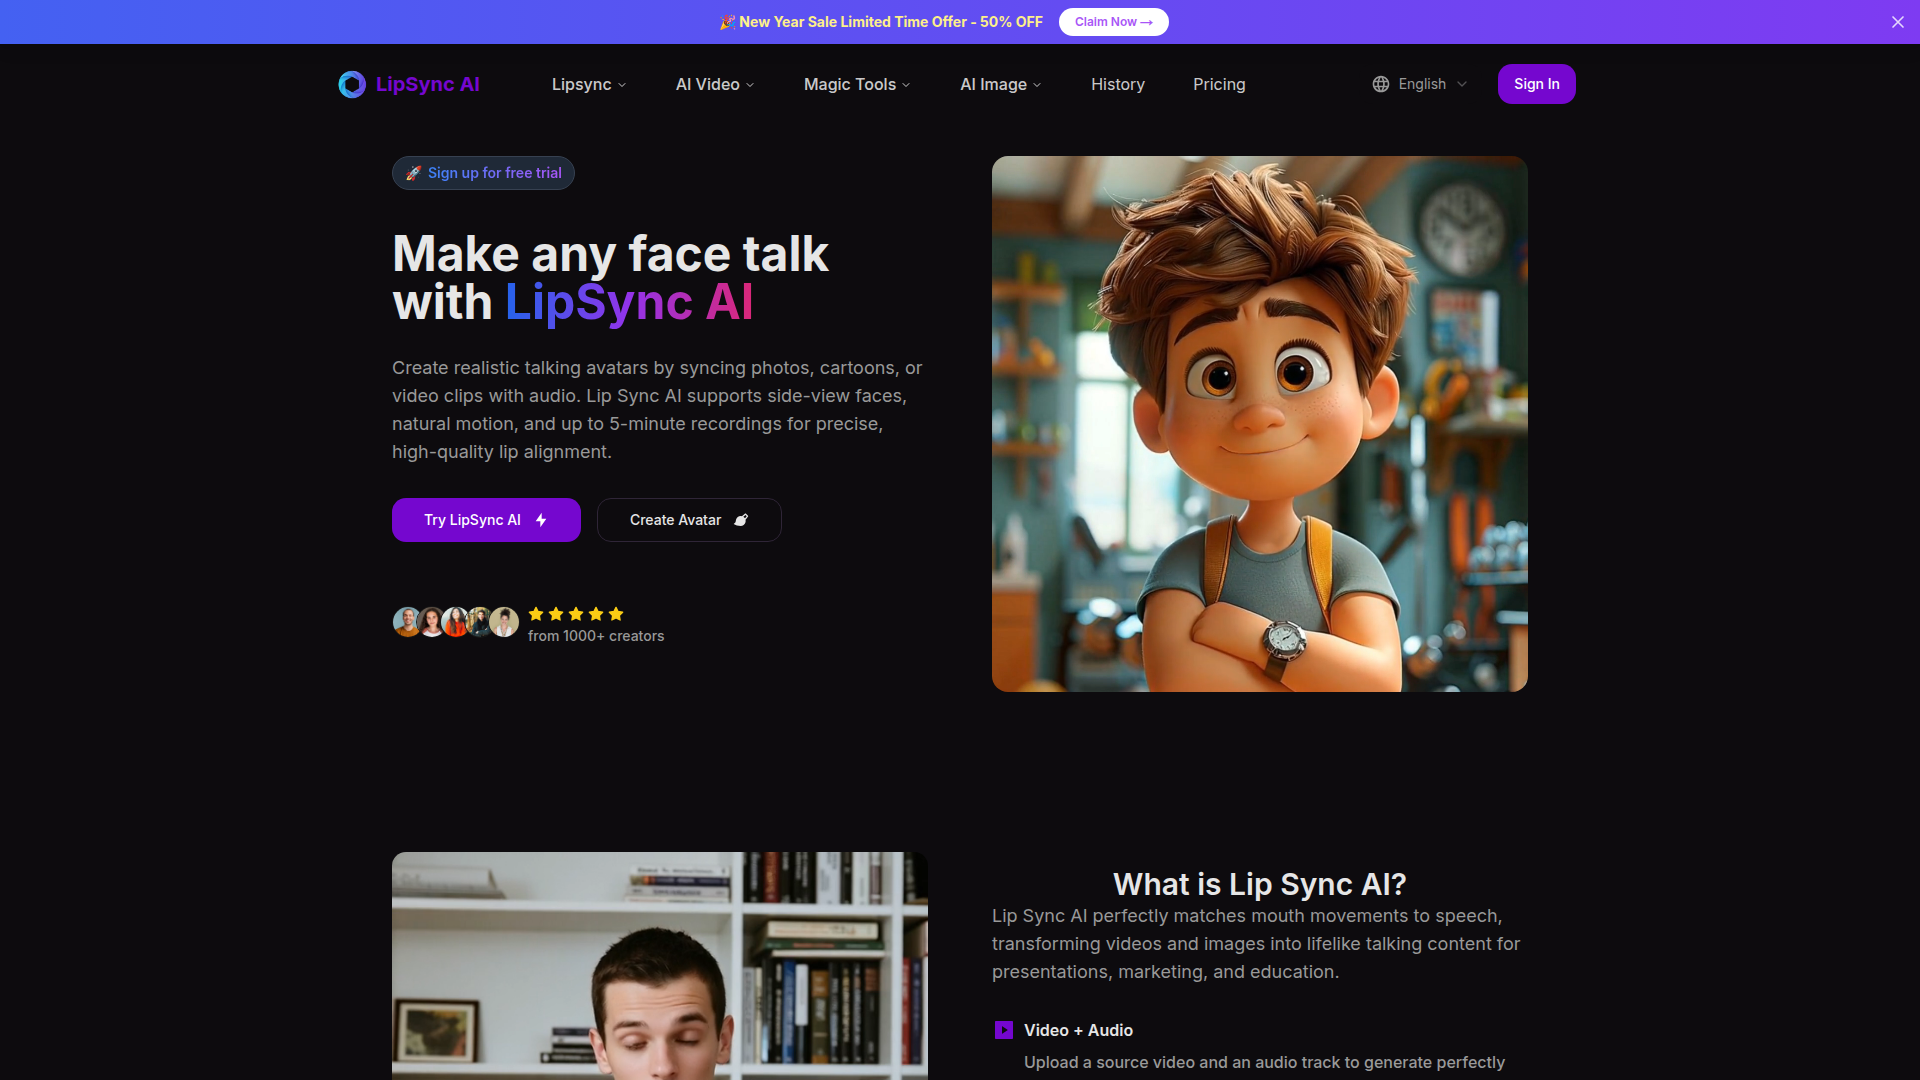
Lipsync AIは、音声と口の動きをAIで同期させるプラットフォームであり、静止画、動画クリップ、またはアニメーションキャラクターをリアルな話すアバターに変換する機能を提供します。ライブ録画を必要とせず、音声ファイルに基づいて高精度の口元アニメーションを生成します。本製品は、プレゼンテーション、教育資料、プロモーション映像、キャラクターベースのストーリーテリングなど、クリエイティブおよび専門的な用途を想定したコンテンツ制作者、教育者、マーケター、開発者向けに設計されています。
プラットフォームは、正面および横顔の人物、非人間キャラクター(例:漫画風キャラクター、動物、スタイライズされたアバター)、および全身映像など、多様な入力形式に対応しており、幅広い応用が可能です。処理は完全にオンラインで実行され、出力は高精細な動画ファイルとして提供されます。これは、元の画像または動画の品質と自然な動きを維持した状態で行われます。
主なポイント
- 3種類の入力モードをサポート:動画+音声、静止画+音声、非人間キャラクター+音声
- 高度な音声分析アルゴリズムを用いた、音素レベルでの正確な口の動き同期
- 同期処理中に元の表情および感情的ニュアンスを保持
- 最大5分間の出力に対応し、複数言語の音声をサポート
- 元の画像または動画の画質を維持した高精細動画出力
- 顔のアップショットに限定されず、全身アバターの同期も可能
- プロダクションワークフローに最適化された高速処理性能
- プライバシー保護:アップロードされたコンテンツはモデル学習に使用されず、処理完了後に自動的に削除される
Lipsync AIの仕組み
Lipsync AIは、3段階のワークフローで動作します。まず、ユーザーは人物(人間または非人間)の動画または静止画をアップロードします。次に、音声ファイル(既存の録音または今後のアップデートで対応予定のテキスト読み上げ音声)を提供します。最後に、AIエンジンが音声波形および音素構造を解析し、音声のタイミング、言語、感情トーンに正確に一致する口の動きアニメーションを合成します。
基盤となる技術は、音響特徴から生体工学的に妥当な発話運動へとマッピングするよう訓練されたディープラーニングモデルです。話し手の訛り、話速、顔の向き(横顔含む)などの変動にも対応し、長時間の処理でも一貫性を保ちます。出力動画は高解像度でレンダリングされ、フレーム間の滑らかな補間により自然な動きが実現されます。
主な利点と用途
Lipsync AIは、複数の業界で実用的な応用が可能です。教育者は、既存の講義スライドやイラストからインタラクティブな授業用アバターを作成できます。マーケターは、単一のスピーカー画像に翻訳されたナレーションを同期させることで、ローカライズされた製品デモを効率的に制作できます。開発者は、インタラクティブアプリケーションやバーチャルアシスタントへの話すアバターの統合を実現できます。コンテンツ制作者は、アクセシブルなSNS投稿、解説動画、多言語チュートリアルを撮影なしで制作できます。さらに、アニメーターおよびゲームスタジオは、音声録音やモーションキャプチャーのリソースが限られている場合においても、キャラクターの会話シーンを迅速にプロトタイピングできます。