SoulMate3Dの紹介
SoulMate3Dは、単一の写真と短い音声録音からリアルタイムで対話可能な3Dデジタルヒューマンを生成するソフトウェアプラットフォームです。故人や遠隔にいる家族、歴史上の人物、あるいは将来の自分自身など、人々が感情的に意味のある持続的なデジタル表現を求めるために設計されています。従来のAIビデオ生成ツールとは異なり、事前にレンダリングされたアニメーションではなく、音声およびテキストによる双方向のライブ対話を可能にします。これは、長期的な会話記憶機能によって支えられています。
このプラットフォームは、喪失や分離に対処する個人、教育者および研究者、そして時間軸を超えたパーソナルなデジタル遺産を構築したいユーザーを対象としています。プライバシーとセキュリティを最優先し、アーカイブメディアではなく、応答可能な具現化された存在としての人間関係の継続を目的とした専用環境を提供します。
主なポイント
- 1枚の写真と10秒の音声録音からリアルタイムで対話可能な3Dデジタルヒューマンを生成
- 事前レンダリングなしで音声およびテキストによる双方向対話をサポート
- セッション間で過去の会話を記憶・参照する長期記憶機能を実装
- 短い音声サンプル(10秒)から自然な抑揚と話者の特徴を再現する音声クローンを構築
- 生成されたモデルや会話履歴を含むすべてのユーザーデータをプライベートかつ安全な環境で管理
- 感情的連続性、教育的活用、または時間軸を超えた自己省察を目的としたデジタルツインの作成を可能に
- 技術的知識を必要とせず、数分でセットアップが完了
- 3D顔モデリング、音声合成、大規模言語モデルの機能を統合したシングルインターフェースを提供
SoulMate3Dの仕組み
ユーザーはまず、対象人物の高解像度正面写真と10秒間の音声録音をアップロードします。システムは画像を3D顔再構成アルゴリズムで処理し、テクスチャ付きでアニメーション可能な3Dメッシュを生成します。同時に、音声サンプルを用いて、話者の特徴的な発声やリズムを再現可能な軽量な音声クローンモデルをトレーニングします。
対話中、ユーザーの音声またはテキスト入力は、セッション履歴および長期記憶ベクトルを組み込んだファインチューニング済みの大規模言語モデルによって処理されます。その応答はリアルタイムでレンダリングされ、3Dアバターの口の動き、表情、頭部の動きが、クローンされた音声モデルによって生成される合成音声と同期します。すべての処理は安全な独立環境内で実行され、ユーザーがアップロードした写真、音声サンプル、会話履歴は外部モデルの学習に使用されず、第三者と共有されることはありません。
主な利点と用途
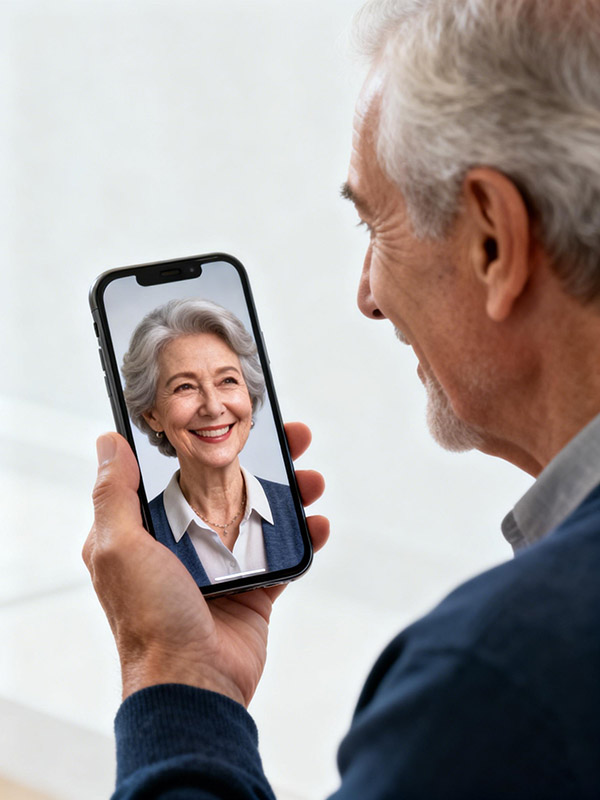
SoulMate3Dは、故人の特徴的な話し方や思い出のフレーズ、文脈に基づく応答を通じて喪失体験に対処するための支援ツールとして活用できます。また、地理的に離れた家族との絆を維持するためにも有効です。例えば、出張や駐在中の親と子供が、本物の声と外見で日常的に対話できるようになります。
教育分野では、歴史上の人物や科学者との模擬対話を通じた学習が可能になります。これは、文献や記録に基づく話者の発声パターンや伝記的情報を反映しています。自己成長の観点からは、若年期の自分をデジタル化して将来の自分へメッセージを送るといった時間軸を超えた自己対話が可能です。さらに、これは体系的なデジタル遺産ツールとしても機能します。単なる視覚的・聴覚的情報の保存ではなく、関係性の文脈と会話の継続性を捉えるものです。