
ASRの書き起こし精度:80%と98%の差を生む、モデル以外の4つの要因
収音機器、録音環境、マイクとの距離、話者の特徴から、音声認識の書き起こし精度を左右する要因を整理。ホットワード、話者分離、単語単位の信頼度、オフライン書き起こしの活用法を紹介します。
この記事のポイント
- モデルだけでは精度は決まらない。 主要エンジンは公開ベンチマークで文字誤り率(CER)5%未満に達していても、実際の業務では精度が80〜90%にとどまることがあります。収音の品質が、その差を生む大きな要因です。
- 確認したいのは4つ。 収音機器、録音環境、マイクとの距離、話者の特徴です。1人で話す場合の目安は、口元からマイクまで30〜50 cmです。
- 用途ごとに期待値を変える。 アナウンサーの朗読、会議、顧客対応の通話では、録音条件も難しさも異なります。
- 録音条件を変えられない場合は、 ホットワード、話者分離、単語単位の信頼度、オフラインの一括書き起こしを活用します。
- 精度改善は、収音・モデル・後処理・人による確認を含む取り組みです。
録音品質が認識結果を左右する
音声認識(ASR)は、スマートフォンの入力、会議用レコーダー、顧客対応システム、動画字幕などに広く使われています。公開ベンチマークでは、主要エンジンのCERはすでに5%未満に達しています。良好な音声信号であれば、専門の書き起こし担当者に近い品質を目指せます。
一方、実際の業務では、人名の誤認識、会議中の似た音の取り違え、インタビューに残る「えーと」「あのー」、さらには30秒の無音区間に文章が生成される問題も起こります。エンジンが安定して力を発揮できるかどうかは、入力音声の品質に左右されます。
DolphinVoiceのエンジニアリング実務では、静かな室内、マイクに近い位置、自然な話速、事前登録した専門用語という条件がそろうと、主要エンジンで95%以上の精度に達する一方、空調音、遠距離収音、発話の重なり、専門用語が多い音声では80〜90%にとどまるケースが見られます。残る5〜10ポイントを改善するには、録音方法にも目を向ける必要があります。
ここでは、書き起こしの誤りが生じる理由と、用途に応じた改善方法を整理します。
音声が文字になるまで
音声認識の処理は、大きく3段階に整理できます。
- 音響特徴の抽出: 波形を25 msなどの短いフレームに分け、スペクトルやメル周波数ケプストラム係数(MFCC)といった特徴を取り出します。
- 音響モデルと言語モデル: 音響特徴から音素などの表現を推定し、言語モデルで単語列を組み立てます。
- 後処理: 大文字・小文字、句読点、話者ラベル、ホットワードによる置換、不適切語のフィルタリング、信頼度の付与などを行います。
入力音声は「どこまで聞き取れるか」を制約し、言語モデルと後処理は「曖昧な部分をどこまで正しく判断できるか」に関わります。前者は録音品質、後者は学習データやカスタマイズの影響を受けます。
 図1:音声入力、音響処理、言語推定、文字出力。録音品質と認識処理の両方が結果に影響します。
DolphinVoiceでは、ホットワードのカスタマイズ、単語単位の信頼度、話者分離を組み合わせて運用します。録音時の物理的な劣化をすべて解消することはできませんが、残っている信号を活用する余地はあります。
フィールド、呼び出し方法、エラーコードはドキュメントをご覧ください。
書き起こしが崩れる4つの要因
収音機器:信号対雑音比を確認する
内蔵マイクは、ノートPC、スマートフォン、タブレットに搭載されています。収音距離の目安は30 cm〜1 m程度で、会議で離れた人の声を拾うと信号対雑音比が下がります。機器の電子ノイズやファンの音も入りやすく、100 Hz〜8 kHz程度の周波数特性では歯擦音の情報が不足することがあります。
外付けマイクは、USB、3.5 mm端子、Bluetoothなどで接続します。収音範囲や感度に加えて、マイク自体の周波数特性と指向性が重要です。安価な全指向性USBマイクは周囲の雑音も拾うため、ノートPCの内蔵マイクより優れているとは限りません。
Bluetoothヘッドセットでは、録音経路のサンプリングレートが8 kHzに制限される場合があります。サンプリングレートはモデルが利用できる音の細かさを左右します。16 kHzのWide Band Speech(HD Voice)で認識に必要な情報を確保でき、それ以上に上げても精度改善につながらない場合があります。AAC、SBC、aptXなどの非可逆圧縮も、伝送時に情報を失う要因です。
専用録音機器を選ぶ際は、周波数特性、サンプリングレート、指向性を確認します。1人の発話には単一指向性(カーディオイド)、円卓には全指向性、対面インタビューには双指向性が選択肢になります。
 図2:4種類の録音機器。用途に合わせて、サンプリングレート、周波数特性、指向性を確認します。
録音環境:雑音の種類を把握する
会議では、マイクアレイを備えたスピーカーフォンが選択肢になります。会議室でノートPCの内蔵マイクを使うと、実用的な収音半径が1 m未満となり、離れた参加者の声が雑音に埋もれることがあります。空調、扇風機、プロジェクターの冷却ファンなど、継続する音を減らしてから録音します。
インタビューは、静かな室内でマイクに近い位置から録音します。本番前に30秒の試し録りを行い、音量、明瞭さ、クリッピングの有無を確認してください。自然な速さで明瞭に話すことが重要です。条件のよいインタビューでは、認識精度が100%に近づく場合もあります。
屋外では、特に風の音への対策が必要です。ウインドジャマーや口元に近いピンマイクを使います。道路交通の雑音は500 Hz〜2 kHz付近で人声の重要な帯域と重なり、認識を妨げます。継続的に屋外で収音するなら、マイクの買い替えだけでなく、ノイズリダクションと話者分離に対応するエンジンも検討します。
 図3:会議では残響と発話の重なり、インタビューでは環境雑音、屋外では風の音に注意します。
録音距離:1人なら30〜50 cmを目安にする
- 近すぎる場合、20 cm未満: 息が直接当たる音や歯擦音で入力が過大になることがあります。
- 遠すぎる場合、60 cm超: 声が小さくなり、環境雑音の割合が増えます。
- 複数人の場合: マイクを中央に置くか、ビームフォーミングに対応するスピーカーフォンを使います。
1人の発話では口元から30〜50 cmを目安とし、円卓では参加者とマイクの距離が大きく偏らないようにします。
 図4:距離が離れるほど声のレベルが下がり、雑音の相対的な割合が増えます。推奨距離の目安は30〜50 cmです。
話者の特徴:話速、同音語、重なり、専門用語
速すぎる発話や不適切な音量。 中国語で毎分250文字を超える話速や、−20 dBFSを下回る音量は、認識率低下の要因として挙げられます。自然な速さと音量で話すことが基本です。この話速は中国語の文字数による目安で、日本語にそのまま当てはめるものではありません。
同音語や似た音の語。 文脈を使って判断する必要がありますが、会議音声では判断材料が十分でないことがあります。
複数人の同時発話。 声が重なると、話者の判定と単語の認識が難しくなります。順番に話す運用と、話者分離に対応するエンジンを組み合わせます。
専門用語や固有名詞。 人名、製品コード、業界用語は、日常会話より誤認識されやすい傾向があります。事前に語彙へ登録し、認識の手がかりを与えます。
 図5:明瞭な発話と、重なりや専門用語に対応するエンジン機能の両方が役立ちます。
用途ごとの精度の目安
録音条件が変わると、書き起こしの難しさにも差が出ます。
| 用途 | 録音条件 | CERの目安 | 運用上のポイント |
|---|---|---|---|
| アナウンサーの朗読 | 1人、静か、近距離、標準的な中国語 | 1%未満 | モデルの性能上限に近い条件 |
| 雑音の少ないインタビュー | 1人、静かな室内、近距離、自然な話速 | 1〜3% | 汎用モデルでも到達可能 |
| 一般的な会議 | 複数人、会議室、スピーカーフォン | 3〜6% | 話者分離とホットワードを利用 |
| 顧客対応の通話 | 複数人、顧客側の雑音、専門用語が多い | 5〜10% | ホットワードのカスタマイズと後処理を利用 |
| 屋外インタビュー | 複数人、風の音、遠距離 | 10〜20% | 物理的な音声劣化の影響が大きい |
これらは公開文献とDolphinVoiceのエンジニアリング経験に基づく参考範囲です。Playgroundでは、公開データセットを使ったDolphinVoiceと主要エンジンの比較を試聴できます。
収音機器、環境、距離、話者の4点を整えることが、良好な録音で精度を80%から98%へ近づけるための出発点です。条件が悪いままでは、モデルを変更しても80〜90%程度にとどまることがあります。
録音条件を変えられない場合の改善策
顧客、現場、パートナーが録音した音声を受け取る場合、収音からやり直すことはできません。DolphinVoiceでは、受け取った音声に対して次の4つの機能を活用できます。
ホットワードのカスタマイズ
人名、製品コード、業界用語、SOPの管理番号などを登録します。DolphinVoiceでは、管理画面またはAPIから数分単位でホットワードの一覧を更新でき、モデルの再学習は不要です。
話者分離
「話者1」「話者2」などのラベルを付け、各話者の発言を時系列で整理します。重なった言葉をすべて認識できない場合でも、議事録で誰が何を話したかを追いやすくなります。
単語単位の信頼度
書き起こし結果を、文章だけでなく信頼度付きの構造化データとして扱います。DolphinVoiceは文と単語ごとに0〜1の信頼度を出力します。業務システムで、人による確認、重要項目の検証、聞き直しの判定に利用できます。
オフラインの一括書き起こし
会議録音の一括登録、翌日の通話品質確認、録音アーカイブでは、即時性より精度と安定性が重視されます。オフライン処理では音声全体を参照できます。同じエンジンのリアルタイム版よりCERが通常1〜3ポイント低く、CPUでの推論に対応し、1台で月3,000時間を処理できる構成が示されています。
月3,000時間は単一マシンの処理能力であり、プランに含まれる利用枠を意味しません。料金は同時処理数や導入形態によって異なります。料金ページをご確認ください。
 図6:録音条件を変えられない場合に活用する、後段の処理機能。
ASRの書き起こし精度:80%と98%の差を生む、モデル以外の4つの要因
管理画面にログインして試用Tokenを取得し、APIをお試しください。初期接続の目安は5分です。
よくある質問
音声認識の精度は、どの程度なら十分ですか?
録音条件によります。静かな室内、近距離、標準的な発音という条件ではCER 1〜3%、精度97%以上が目安です。雑音を含む通話、会議、屋外録音ではCER 5〜15%の範囲も想定されます。まず音声の条件を分類してから評価します。
自分の録音だけ精度が低いのはなぜですか?
代表的な原因は、マイクが遠い、環境雑音が続いている、複数人が同時に話す、専門用語が未登録という4点です。エンジンを変更する前に、録音方法とホットワードの設定を確認してください。
マイクは口元からどのくらい離しますか?
1人なら30〜50 cmが目安です。20 cm未満では息や歯擦音が過大入力につながり、60 cmを超えると声に対する雑音の割合が増えます。会議では中央に設置し、参加者との距離をそろえます。
複数人の会議で精度を上げるには?
マイクアレイを備えたスピーカーフォンを使い、空調やファンなどの継続音を減らし、話者分離を有効にします。声が重なった場面でも、発言者を追いやすくするための対策です。
専門用語や人名、製品コードが毎回間違う場合は?
頻出する用語、人名、製品コード、管理番号をホットワードへ登録します。DolphinVoiceでは、管理画面またはAPIから数分単位で更新でき、モデルの再学習は不要です。
オフラインとリアルタイムでは、どちらが正確ですか?
オフラインでは音声全体と後続の文脈を使えるため、同じエンジンでも曖昧な部分を判断しやすくなります。CER改善の目安は1〜3ポイントです。即時性が不要な会議録音の登録、通話品質確認、アーカイブにはオフラインが適しています。
精度をシステム全体で評価する
「95%、97%、99%」という数字だけでは、実際の業務で使えるかは判断できません。収音品質は聞き取れる情報を、学習データとモデル構造は認識を、ホットワードと話者分離は業務への適合を、信頼度と人による確認は残った誤りへの対応を左右します。
これらを整えることで、80%の用途で98%以上の精度を維持できるという目安も示されています。録音条件や評価方法と合わせて検討することが必要です。
具体的な用途の精度評価は法人向け窓口へご相談ください。会社概要では、企業背景と技術の方向性を紹介しています。
DolphinVoiceを試す
Playground
Playground:公開データセットのCERと比較音声を確認。
料金ページ
料金ページ:料金、同時処理数、導入形態を確認。
ログイン
ログイン:試用Tokenを取得。
お問い合わせ
お問い合わせ:具体的な録音用途を相談。
会社概要
会社概要:企業背景を確認。
ドキュメント
ドキュメント:接続方法を確認。
データの参照範囲
- 主要エンジンのCER 5%未満: CSJ、AISHELL、TED-LIUMなどの公開音声認識ベンチマークのベースライン。
- 用途ごとのCER 1〜20%: 公開文献とDolphinVoiceのエンジニアリング経験。
- サンプリングレートとWide Band Speech: 16 kHzのHD Voiceで認識に必要な情報を確保するという技術的な考え方。
- マイクの指向性: カーディオイド、全指向性、双指向性、スーパーカーディオイド、ハイパーカーディオイド、バイノーラルなどの一般的な分類。
記事を共有
もっと読む
10分で導入:発音評価 Android SDK を組み込む
テスト認証情報の取得と AAR の導入から、DolphinSOE の初期化、録音・ファイル評価、結果コールバックまでを Android Demo で確認します。
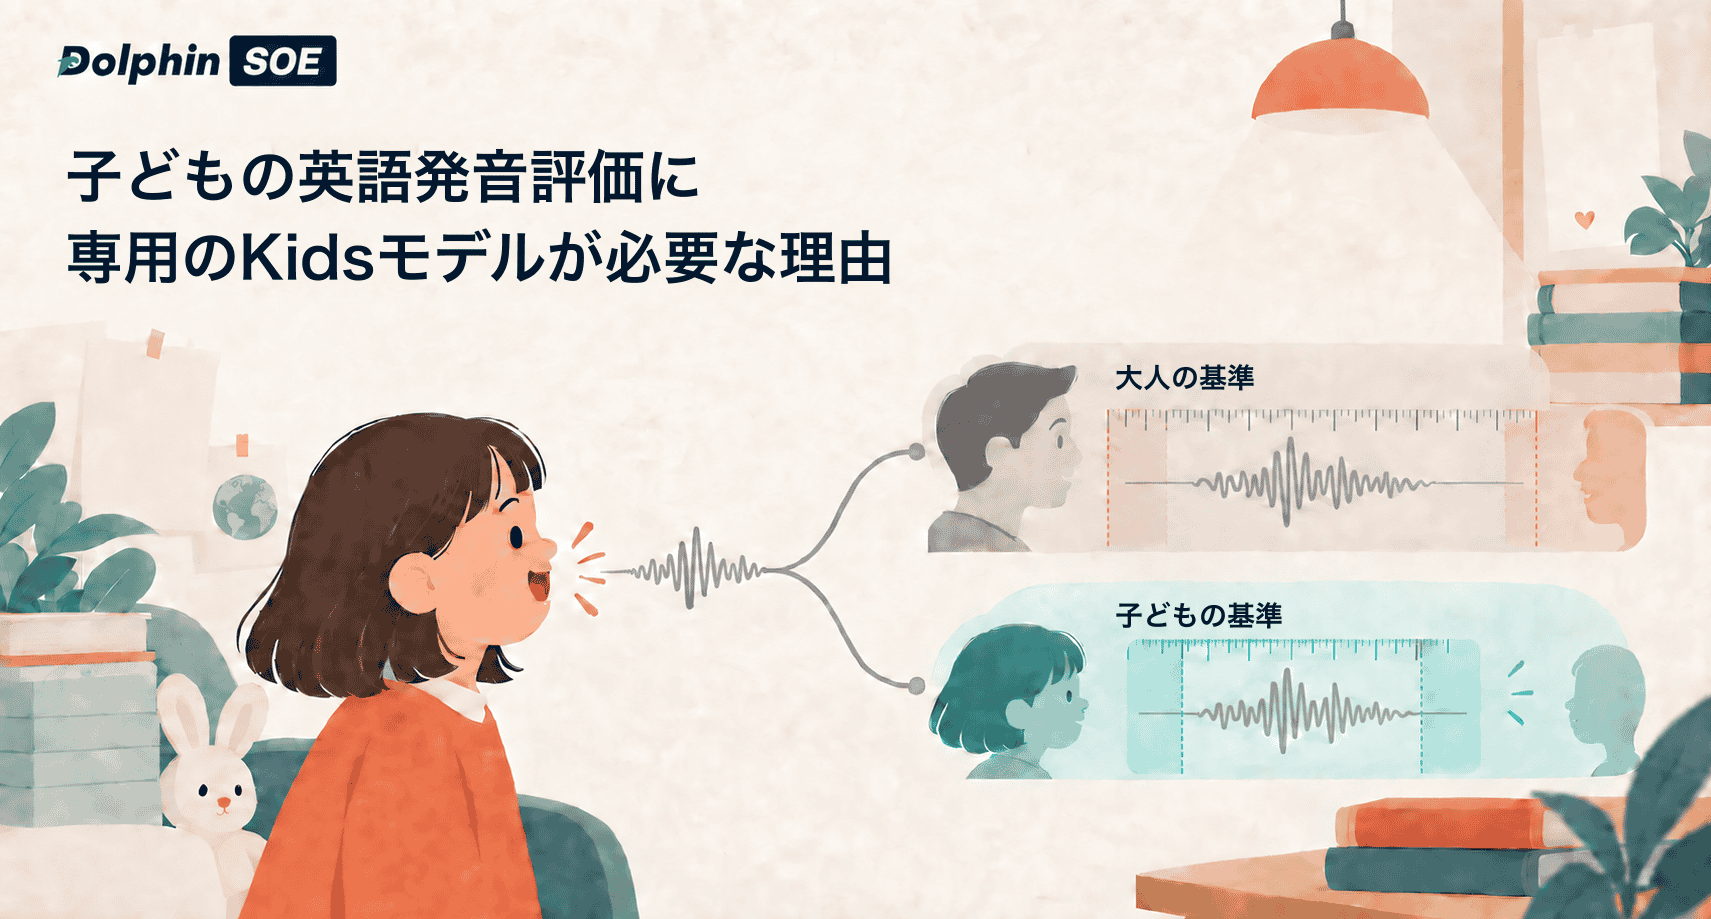
子どもの英語発音評価に専用のKidsモデルが必要な理由
子どもの英語発音評価にKidsモデルが必要な理由を解説。音響特性の違い、採点の校正、DolphinSOEの対応形式と切り替え方法を紹介します。
26,000件の診療記録のほぼすべてに捏造内容:Whisperのハルシネーションの構造的リスクと商用対策
Whisperはなぜ無音区間で文全体を捏造するのでしょうか。APの調査報道とコーネル大学の研究をもとに、LLMデコーダーのハルシネーションの原因、四つの商用場面での代償、後処理では解決できない理由と、実践できる無音区間のテスト項目を解説します。