
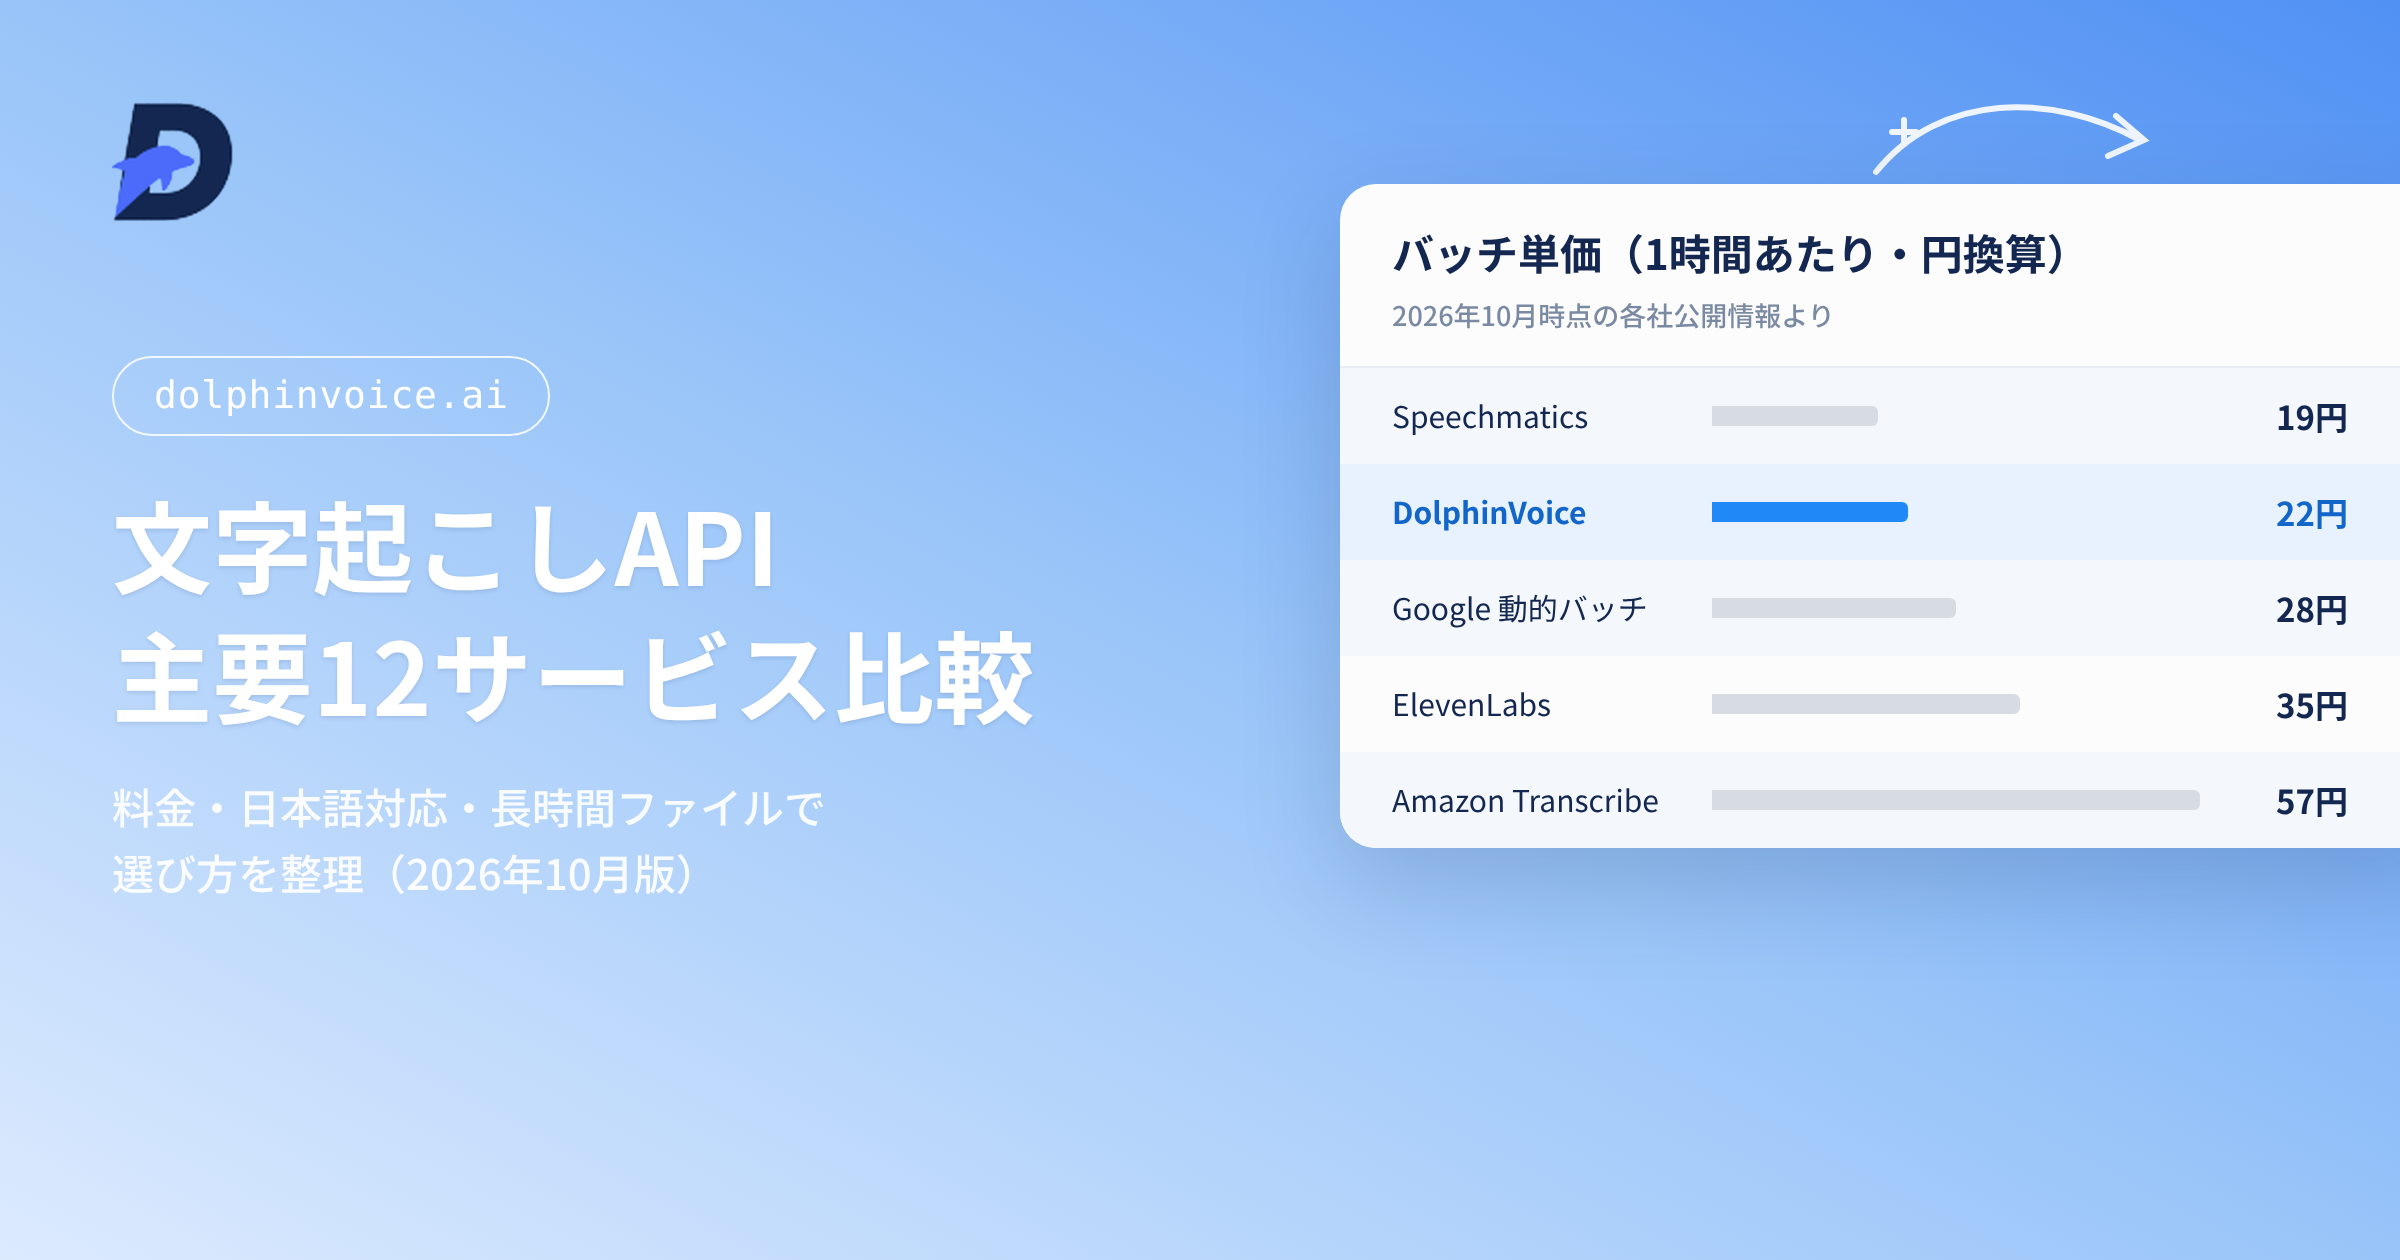
文字起こしAPI 12選を比較
料金、日本語対応、長時間ファイルの上限、話者分離、データ保護、オンプレミス対応の6つの観点から、用途に合うAPIの選び方を解説します。掲載情報は2026年10月時点のものです。
録画した会議を自動でテキスト化したい。コールセンターの通話録音を一括で書き起こして分析したい。インタビュー音源の文字起こしを外注せずに自社のプロダクトで完結させたい。こうした要件を満たすのが文字起こしAPIです。
この記事を書いているのは、文字起こしAPI「DolphinVoice」を提供している株式会社DolphinAIです。自社サービスも比較対象に含むため、この記事では順位づけをしていません。 各社が公開している料金ページ・APIリファレンス・データポリシーに書かれている数値をそのまま並べ、その読み方を解説する形にしています。弊社のDolphinVoiceについては記事の後半に独立したセクションを設け、向かないケースもあわせて書きました。
この領域は2026年後半に入って状況が大きく動いています。ElevenLabsがScribe v2とそのリアルタイム版を投入し、MicrosoftはMAI-Transcribe-2を1時間あたり0.10ドルという価格でプレビュー提供を開始。AssemblyAIはUniversal-3.6 Proを出してストリーミングの対応言語を32言語に拡大し、Deepgramはストリーミング専用のFluxを追加しました。2026年前半に書かれた比較記事の多くは、これらをまだ反映していません。弊社も自社の開発・営業のために各社の情報を定点で追っているため、2026年10月時点の最新の状態を整理して公開します。
記事の前半では「料金」「日本語対応の実態」「長時間ファイルの扱い」「話者分離・カスタム辞書」「データの取り扱い」「オンプレミス可否」という6つの比較軸を整理し、後半で主要12サービスの公開情報をまとめています。自社に合うAPIを見極める材料としてお使いください。
文字起こしAPIとは?バッチ処理とリアルタイム処理の違い
技術的には文字起こしAPIと音声認識API(STT/ASR)は同じものを指しますが、実務では力点が少し違います。
文字起こしAPIという言い方をするときは、すでに録音・録画された音声ファイルをまとめてテキスト化するバッチ処理(非同期処理)を指していることがほとんどです。会議録画、インタビュー音源、通話録音、動画の字幕制作などが典型で、リアルタイム性よりも「長時間のファイルを安く・速く・正確に処理できるか」が評価軸になります。一方、通話中の画面にその場でテキストを出す、ボイスボットが応答する、といった用途はリアルタイム(ストリーミング)処理で、こちらは遅延が中心的な評価軸です。
この記事はバッチ処理を主軸に置きつつ、リアルタイムの対応状況も併記します。同じサービスでもバッチとリアルタイムで単価が1.5倍から3倍変わるため、自社の用途がどちらに寄るかを先に決めてください。
そしてもう1つ、文字起こしには完成品SaaSとAPIという分かれ道があります。ブラウザに音声をアップロードして画面上で編集するタイプがSaaS、音声をHTTPやWebSocketで送るとJSONが返ってくるのがAPIです。自社プロダクトの機能として文字起こしを提供したいならAPI一択で、この記事はAPIだけを扱います。
文字起こしAPIを選ぶ6つのポイント
料金:1時間あたりの総額で比べる
文字起こし用途ではバッチ(非同期)の単価を見ます。ここを1時間あたりに統一して比べるのが第一歩です。「$0.006/分」と「$0.21/時」は、そのままでは比較できません。
比較の際に揃えるべきは次の4点です。
- 課金単位:1分単価×60で時間単価に統一する
- 通貨と税:海外勢は米ドル・税抜、国内勢は円・税込が中心
- 為替:2026年10月時点のドル円は158円前後。ドル建てのサービスは、円安が進むと単価据え置きでも円換算の原価が上がります
- オプション課金:話者分離、PII削除、要約などが別料金かどうか
特に為替は、月間処理時間が大きいサービスほど効いてきます。ドル建てのAPIを使うなら、想定レートを±10%動かした感度分析を事業計画に含めておくことをおすすめします。
追加課金項目も見落としやすいポイントです。AssemblyAIの話者分離は事前録音で$0.02/時・ストリーミングで$0.12/時の追加、ElevenLabsの話者ロール判定は10%加算になります。基本単価だけを比べると、必要な機能を足した時点で順番が入れ替わることがあります。
日本語:モデルごとの対応と認識精度を確認する
「日本語対応」は、サービス単位ではなくモデル単位で確認してください。2026年10月時点でも、同じベンダーの中で対応状況が分かれています。
AssemblyAIが典型です。2026年8月時点ではストリーミングの対応言語が6言語で日本語が含まれていませんでしたが、現在はUniversal-3.5 Pro StreamingとUniversal-3.6 Pro Streamingが日本語に対応しています。ただし廉価なUniversal-Streaming($0.15/時)は依然として英語・スペイン語・ドイツ語・フランス語・ポルトガル語・イタリア語の6言語のみで、日本語では使えません。安いほうの単価で試算して、実際は$0.45/時のモデルが必要だった、という食い違いが起きやすい構造です。
Deepgramも同様で、日本語は多言語モデル扱いになり、英語向けの単一言語モデル単価(事前録音$0.0043/分)ではなく多言語単価($0.0052/分)が適用されます。
MicrosoftのMAI-Transcribe-2は$0.10/時という攻めた価格ですが、公式ブログに言語リストの記載がなく、日本語対応の可否が確認できません。価格だけで判断するのは避けたほうがよい部分です。
精度については、各社とも「業界最高精度」といった表現は使うものの、日本語に限定した公式のWER(単語誤り率)を公開しているベンダーは、各社の公開ページを確認した範囲では見当たりませんでした。英語ベンチマークの数値は日本語の精度を保証しません。これは弊社も含めた業界全体の課題で、日本語精度は実データで測るしかない、というのが率直なところです。
長時間音声:ファイル上限と処理時間を確認する
文字起こし用途でバッチを使うなら、ここが実装の難易度を左右します。
OpenAIはファイル上限が25MBです。MP3で2時間弱、WAVなら10分程度に相当します。2時間の会議録画をそのまま投げることはできず、分割と結合の処理を自前で書く必要があります。実装を始めてから気づくと手戻りになる制約です。対してElevenLabsは1GBまたは4.5時間、弊社のDolphinVoiceは音声1GB・動画2GB・長さ5時間まで受け付けます。Speechmaticsのオンプレミス版バッチコンテナは2時間または4GBが上限と明記されています。
処理速度も重要です。Azureのバッチはおおむね実時間の5倍速で処理され、90パーセンタイルで6時間未満、ピーク時は最大24時間かかる場合があると公式に記載されています。朝アップロードして夕方までに結果が欲しい運用には向きますが、ユーザーが画面の前で待つ設計には使えません。同じ「バッチ」でも、設計できるUXが処理速度で変わります。
 1ファイルで扱える長さの上限の比較
実用機能:話者分離とカスタム辞書を確認する
話者分離(ダイアライゼーション) は、Amazon Transcribeが最大30話者、ElevenLabsが最大32話者に対応し、ElevenLabsは話者ロール判定(エージェントと顧客の区別)もオプションで持ちます。AssemblyAIは想定話者数や範囲を指定可能、Speechmaticsは声による分離・チャンネル別分離・両者の組み合わせの3モード。OpenAIは話者分離専用のgpt-4o-transcribe-diarizeを使います。なお2チャンネル録音(オペレーターと顧客が別チャンネル)が取れる環境なら、声による分離よりチャンネル分離のほうが確実かつ安価です。
カスタム辞書/キーワードブースト は上限が各社で大きく異なります。Deepgramは最大100語・500トークン上限、Speechmaticsは1ジョブあたり最大1,000語で読み方の指定にも対応(日本語は全角ひらがな・カタカナのみ)、AssemblyAIはUniversal-3.5 Proで$0.05/時の追加課金・Universal-2は無料で込み。社名や製品名が数百語ある業務では、この上限が実用性を直撃します。
Amazon Transcribeの公式ドキュメントには「カスタム語彙に登録しても正しく認識される保証はない」という記述があります。辞書は万能ではなく、登録語数の上限と実際に効くかどうかをPoCで検証するのが前提です。
データ保護:学習利用と保存条件を確認する
企業導入では法務・情報セキュリティ部門のレビューが入ります。各社のスタンスは明確に分かれます。
| ベンダー | 学習利用・保持のスタンス(公式記載) |
|---|---|
| Amazon Transcribe | サービス改善に利用する場合があり、デフォルトは利用される状態。AWS Organizationsのポリシーで明示的にオプトアウトが必要 |
| Google Cloud STT | デフォルトでは音声・文字起こしをログ記録しない。ロギングにオプトインすると割引と引き換えに品質改善に利用。ログデータはプロジェクト削除では消えず、削除に申請が必要 |
| Azure AI Speech | リアルタイムでは「顧客提供データを保持・保存しない」「音声はサーバーメモリ上でのみ処理」と明記。バッチは保存先を顧客が指定 |
| OpenAI | 明示的にオプトインしない限り学習に利用しない。最大30日保持後に削除。条件を満たせばゼロデータ保持(ZDR)を申請可 |
| Deepgram | モデルの学習・テストに利用する場合があるがリクエスト単位でオプトアウト可。セルフホストでは音声・文字起こしがDeepgramに送信されないと明記 |
| AmiVoice | ログ保存ありのほうが安い料金構造(汎用・非同期HTTPで79.2円/時 対 99円/時) |
| DolphinVoice(弊社) | ログ保存あり/なしで同一料金。ISO 27001/SOC 2/APPIに対応しています |
議事録や通話録音には個人情報と営業機密が高い密度で含まれます。「ログを渡さない選択をしたときに単価が上がるのか、変わらないのか」は、情シスレビューを通すうえで実務的に効く差分です。
提供形態:オンプレミスとセルフホストに対応できるか
音声を外部に出せない要件がある場合、候補は一気に絞られます。2026年10月時点でオンプレミス/セルフホスト提供を確認できたのは以下です。
- Azure AI Speech:Speech to textコンテナはGA。ただし切断(disconnected)運用は申請と約10営業日の承認が必要
- Deepgram:Docker/Podman、Kubernetes、ベアメタル、SageMakerに対応。Docker/K8sはEnterpriseプラン加入が必須
- Speechmatics:Dockerコンテナ、Kubernetes、仮想アプライアンス、Mac/WindowsのOn-Device版。ただしオンプレ版はSaaS版より機能が限定
- AmiVoice API Private:クラウド/オンプレ両対応。プライベート接続は初期費用132,000円+月額55,000円+API利用料の5%
- NTTテクノクロス SpeechRec:オンプレミス・プライベートクラウドで構築可能。同時接続数単位の年間ライセンス
- DolphinVoice(弊社):お客様の施設・管理サーバー内での実行に対応しています(法人向けの提供形態)
一方、Google Cloud Speech-to-Text、Amazon Transcribe、OpenAI、AssemblyAI、ElevenLabsはオンプレミス提供の公式記載を確認できませんでした。ここで総コストを左右するのがGPU要否です。GPU前提の構成はサーバー調達費と電力コストが跳ね上がるため、CPUで動作する構成を提供できるかどうかは、オンプレ案件の見積りを数倍変えます。
文字起こしAPI比較表:料金・無料枠・ファイル上限
2026年10月時点で各社公式ページから確認した内容です。ドル建て料金の円換算はドル円158円による参考値で、海外勢は税抜、国内勢は税込表示です。掲載順は国内・海外プラットフォーマー・音声特化ベンダー・セルフホストの順で、順位づけではありません。
 文字起こしAPI バッチ単価の比較(1時間あたり・円換算)
| サービス | バッチ料金(1時間換算) | 無料枠 | ファイル上限 | 話者分離 | オンプレ |
|---|---|---|---|---|---|
| DolphinVoice(弊社) | 22円(税込・標準版)/66円(急速版) | 毎月600分+TTS1万文字 | 音声1GB・動画2GB・5時間 | 対応 | 対応 |
| AmiVoice | 79.2円〜(税込・汎用・ログ保存あり) | 各エンジン毎月60分 | 公式記載なし | 対応 | 対応(Private) |
| NTTテクノクロス SpeechRec | 年間ライセンス(非公開) | 記載なし | 公式記載なし | 対応 | 対応 |
| Google Cloud STT | 標準$0.016/分=約152円;動的バッチ$0.003/分=約28円 | V1のみ月60分 | 公式記載なし | 日本語行に記載なし | 確認できず |
| Amazon Transcribe | $0.006/分=約57円 | 新規12か月・月60分 | 公式記載なし | 対応(最大30話者) | 確認できず |
| Azure AI Speech | 標準単価は未確認;MAI-Transcribe-2 $0.10/時=約16円 | 月5時間(リアルタイムのみ) | 公式記載なし | 対応 | コンテナ提供 |
| OpenAI | gpt-4o-mini $0.003/分=約28円;gpt-transcribe $0.0045/分=約43円 | 記載なし | 25MB | diarize専用モデル | 確認できず |
| ElevenLabs Scribe v2 | $0.22/時=約35円 | プランに含有時間あり | 1GB/4.5時間 | 対応(最大32話者) | 確認できず |
| Deepgram Nova-3 | 多言語(日本語)$0.0052/分=約49円 | $200クレジット | 公式記載なし | 対応 | 対応(Enterprise) |
| AssemblyAI | Universal-2 $0.15/時=約24円;Universal-3.5 Pro $0.21/時=約33円 | 事前録音185時間 | 公式記載なし | +$0.02/時 | 確認できず |
| Speechmatics | Melia 1 $0.12/時=約19円;Enhanced $0.38/時=約60円 | $100クレジット | オンプレ版2時間/4GB | 対応(3モード) | 対応 |
| セルフホストWhisper | ライセンス費ゼロ(GPU費用は自社負担) | — | 自社構成次第 | 別途実装 | 対応 |
※Azureの標準単価は公式料金ページが動的表示のため取得できませんでした。MAI-Transcribe-2の$0.10/時は公式ブログで公表された2026年12月31日までの価格で、プレビュー段階かつ日本語対応の明記がありません。
※Deepgramの日本語は多言語モデル扱いのため、英語向け単一言語単価($0.0043/分)ではなく多言語単価で記載しています。
※AssemblyAIの話者分離はストリーミングでは+$0.12/時になります。
主要12候補の特徴と導入時の注意点
ここから各サービスの特徴を整理します。繰り返しになりますが、この記事は弊社が書いているため順位づけはしていません。 国内ベンダー、海外プラットフォーマー、音声特化ベンダー、セルフホストという順に並べ、弊社のDolphinVoiceは最後にまとめています。
AmiVoice Cloud Platform:医療・金融などの専門分野に対応
国内で最も知名度の高いサービスです。強みは領域特化エンジンで、汎用に加えて医療・金融・保険・多言語・氏名認識・住所認識を型番付きで公開し、言語モデルと音響モデルを組み合わせて選べます。医療カルテや保険の窓口対応など、専門語彙が精度を左右する領域では有力な選択肢です。
料金は税込表示で、文字起こし用途にあたる汎用エンジン・非同期HTTPが、ログ保存ありで79.2円/時、ログ保存なしで99円/時。医療エンジンは148.5〜222.75円/時、金融・保険・多言語は118.8〜148.5円/時です。無料枠は各エンジンそれぞれ毎月60分で、課金は発話区間のみという点も実務的です。ISO/IEC 27001(登録番号IS 816102)を取得しています。
留意点:ログ保存ありのほうが安い料金構造のため、録音データを外部に残せない要件では実質的にコストが上がります。公式ページは税込表記のみで、税抜単価は確認できません。
NTTテクノクロス SpeechRec:オンプレミスで構築する音声認識基盤
WebSocket接続によるリアルタイム処理、話者ダイアライゼーション(1チャンネルに複数話者がいる場合も発話ごとに分類)、ユーザ辞書に対応し、オンプレミス・プライベートクラウドで構築できます。国内大手の調達要件に合わせやすい点が実務上の価値です。
留意点:料金は非公開で、同時接続数単位の年間ライセンス提供です。従量課金で小さく始めることはできず、初期の技術検証にも商談プロセスが必要になります。
Google Cloud Speech-to-Text:動的バッチで大量の音声を処理
V2 APIではChirp/Chirp 2が使え、日本語で自動句読点、モデルアダプテーション、単語レベル信頼度に対応します。標準は$0.016/分(約152円/時)と高めですが、Dynamic Batch(動的バッチ認識)は$0.003/分(約28円/時)と標準比81%引きで、即時性が不要な大量処理では安価です。従量の階段もあり、月50万分を超えると$0.010/分、100万分超で$0.008/分、200万分超で$0.004/分まで下がります。デフォルトで音声・文字起こしをログ記録しない点も評価できます。
留意点:V2の料金表に無料枠の記載がなく(無料枠は月60分のV1のみ)、言語サポート表の日本語行に話者分離の記載がありません。マルチチャンネル音声はチャンネルごとに課金されるため、2チャンネル録音では単価が実質2倍になります。なお公式リリースノートの最新更新は2025年11月で、2026年に入ってからの大きな動きは確認できていません。
Amazon Transcribe:AWS環境での連携を重視する場合に
バッチ$0.006/分(約57円/時)、ストリーミング$0.01/分。日本語はバッチ・ストリーミング両対応で、カスタム言語モデルも両対応です。話者分離は最大30話者。新規ユーザーは月60分を12か月間無料です。S3へのファイル配置をトリガーにLambdaで処理を回す、Amazon Connectの通話録音をそのまま処理する、といったAWS内での連携は最短距離で組めます。自動コンテンツ削除や生成AI通話要約がアドオンとして用意されている点も、通話分析用途では実装量を減らせます。
留意点:日本語では頭字語とPII削除が非対応、Call Analyticsは通話後のみでリアルタイム非対応です。データポリシーはデフォルトで学習利用される設定で、AWS Organizationsのオプトアウトポリシー設定が必要な点は情シスレビューの論点になりやすい部分です。
Microsoft Azure AI Speech:クラウドとコンテナの提供形態を比較
日本語でFast transcriptionに対応し、Custom Speechではフレーズリストや構造化テキストでカスタマイズできます。リアルタイムでは「顧客提供データを保持・保存しない」と明記されており、データポリシーの明快さは各社のなかでも上位です。Speech to textコンテナがGAでオンプレ対応もあります。
2026年9月に発表されたMAI-Transcribe-2は$0.10/時(約16円)という価格で、本記事で取り上げた中では最も安い水準です。2026年12月31日までの価格として公式ブログに記載されています。
留意点:MAI-Transcribe-2はプレビュー段階で、公式ブログに言語リストがなく日本語対応が確認できません(同記事内で対応言語数が60言語と43言語で食い違ってもいます)。そして標準のSpeech to text単価は、公式料金ページがJavaScript動的描画のため確認できませんでした。実導入の試算はAzure料金計算ツールでの確認が必須です。切断コンテナの利用には申請と約10営業日の承認プロセスもあります。
OpenAI:文字起こしから要約までを連携
主力はgpt-transcribe($0.0045/分=約43円/時)で、gpt-4o-transcribe($0.006/分)、gpt-4o-mini-transcribe($0.003/分=約28円/時)も提供されています。話者分離が必要な場合はgpt-4o-transcribe-diarizeを使い、話者ラベル付きのJSONを取得できます。文字起こしの後に要約・議事録整形・アクションアイテム抽出まで同じプラットフォームで完結できる点が実務上の強みで、既存のOpenAI SDKがそのまま使えるため実装の立ち上がりは最速の部類です。
留意点:ファイル上限25MBは文字起こし用途では小さく、長時間音声は分割処理の実装が必須になります。単語・セグメント単位のタイムスタンプはレガシーのwhisper-1のみ対応で、字幕制作用途では制約になります。公式ガイドに明示的な対応言語リストがなく、日本語対応の公式な明記は確認しづらい状態です。
ElevenLabs Scribe v2:長時間音声と多人数の会議に対応
音声合成で知られるElevenLabsが文字起こしにも本格参入し、2026年後半にScribe v2へ世代交代しました。バッチが$0.22/時(約35円)、WebSocket接続のScribe v2 Realtimeが$0.39/時(約62円)です。
文字起こし用途での強みはファイル上限1GB/4.5時間という受け入れ幅です。長時間の会議録画やセミナー音源を分割せずにそのまま投げられます。話者分離は最大32話者に対応し、話者ロール判定(エージェントと顧客の区別、10%加算)も持つため、多人数会議やコールセンター録音の構造化に向きます。日本語は高精度群として公式ドキュメントに掲載されています。
留意点:Scribe v2 Realtimeの遅延は公称150msですが、同一ページ内に「100ms未満」という記述もあり表記が揺れています。またリアルタイム版の話者分離可否は公式FAQに回答が載っておらず未確認です。オンプレミス提供の記載も確認できていません。
Deepgram:セルフホストと専門分野向けモデルを選択
Nova-3系を中心に事前録音とストリーミングの両方を提供します。日本語は多言語モデル扱いで、事前録音$0.0052/分(約49円/時)、ストリーミング$0.0058/分です。2026年後半にストリーミング専用のFluxが加わり、Nova-3 Pharma(製薬)の追加とNova-3 Medicalの多言語化も行われました。$200クレジット(有効期限なし・カード不要)で試せます。セルフホストはDocker/Podman、Kubernetes、ベアメタル、Amazon SageMakerに対応し、セルフホスト構成では音声・文字起こし・リクエスト内容の識別情報がDeepgramに送信されないと明記されています。
留意点:Docker/KubernetesでのセルフホストはEnterpriseプラン加入が必須で価格は要問い合わせです。現在のストリーミング価格は「期間限定プロモ価格」と明記されており、通常価格は単一言語$0.0077/分・多言語$0.0092/分。終了日が公表されていないため、プロモ価格を前提に原価設計するのは避けたほうが安全です。カスタム辞書は最大100語という制約もあります。
AssemblyAI:無料枠とモデルごとの機能を比較
事前録音はUniversal-2が$0.15/時(約24円)、Universal-3.5 Proが$0.21/時(約33円)。無料枠が事前録音185時間・ストリーミング333時間と大きく、検証コストがほとんどかかりません。2026年後半にUniversal-3.6 Proが加わり、ストリーミングの対応言語が32言語に拡大しました。
日本語の扱いが2026年8月から変わった点は重要です。 以前はストリーミングで日本語が使えませんでしたが、現在はUniversal-3.5 Pro StreamingとUniversal-3.6 Pro Streamingで日本語に対応しています。ただし廉価なUniversal-Streaming($0.15/時)は依然6言語で日本語非対応のままなので、単価を見るときはモデル名まで確認してください。
留意点:話者分離が事前録音で$0.02/時、ストリーミングで$0.12/時の追加課金です。オンプレミス提供の公式記載は確認できていません。
Speechmatics:バッチ処理とオンプレミスの選択肢
2026年後半に小幅な値下げがあり、Melia 1(バッチ)が$0.12/時(約19円)、Standardが$0.23/時、Enhancedが$0.38/時になりました。医療特化のOak 1 Medicalが$0.15/時で加わっています。バッチ単価の安さでは本記事で取り上げた中の最安帯で、月500時間超で最大25%のボリューム割引もあります。カスタム辞書は1ジョブあたり最大1,000語と各社のなかで最大級で、日本語では全角ひらがな・カタカナで読みを指定できます。話者分離は3モード、デプロイはCloud/On-Premises/On-Deviceの3種類が揃います。
留意点:日本語がバッチ・リアルタイムそれぞれで使えるかは言語ページに明記がなく、契約内容によって利用可否が変わる旨の注記があるため事前確認が必要です。オンプレ版はSaaS版より機能が限定されます。料金ページ内で$0.12と$0.121の表記揺れがあり、小数第3位は未確定です。
Whisperの自前運用:GPU費用と運用負担を見積もる
ライセンス費用がゼロという点は魅力ですが、実運用ではGPUサーバーのコスト、モデル更新、監視、障害対応を自社で抱えます。同時処理数を確保するためのGPU台数まで含めた総保有コスト(TCO)で比較すると、月間処理時間が一定規模以下であればクラウドAPIのほうが安くなるケースが多くなります。加えて話者分離やカスタム辞書、句読点付与は別途実装が必要で、商用APIが標準で持つ機能を自前で用意する工数も計算に入れる必要があります。
GPU前提の構成とCPUで動く商用エンジンではサーバー原価の構造そのものが変わるため、オンプレ要件があるからWhisperしかない、と決める前にCPUベースの商用エンジンも比較対象に入れることをおすすめします。
DolphinVoice:円建て料金とオンプレミス対応
ここは弊社自身のサービスについてのセクションです。他社と同じ基準で読んでいただけるよう、公開している数値と、向かないケースの両方を書きます。
料金・無料枠・ファイル上限
録音ファイル書き起こしは標準版が22円/時、急速版が66円/時、リアルタイム音声認識が66円/時です。すべて円建て・税込で公開しており、月額固定費はありません。処理速度は標準版が1時間の音声を最短10分、急速版が最短2分です。
 DolphinVoice の料金と上限
無料枠は音声認識が毎月600分、音声合成が毎月10,000文字。同時処理は無料枠でリアルタイム認識10チャネル、録音ファイル書き起こし2チャネルまで利用できます。月間5,000時間以上をご利用の法人のお客様には段階制料金を適用しており、稼働率などの条件も公開しています。
ファイルの上限は音声1GB・動画2GB・長さ5時間です。標準版はWAV、PCM、OPUS、MP3、MP4、M4A、AMR、3GP、AACに対応し、出力は原稿形式と字幕形式の両方を選べます。対応言語は日本語・英語・中国語で、中英混在・日英混在にも対応しています。
認識機能と導入形態
機能面はホットワード・単語辞書登録、NGワード/強制置換のカスタマイズ、話者識別、話速計算、非流暢性(言いよどみ)の検出、逆テキスト正規化(ITN)に対応しています。
技術基盤はCPU中心の自社アーキテクチャで、GPUサーバーを前提としない構成が可能です。オンプレミス構成ではお客様の施設・管理サーバー内での実行に対応しています。ログ保存あり/なしで単価が変わらない設計にしているため、録音データを外部に残せない要件でもコストが上がりません。情報セキュリティについてはセキュリティページでISO 27001/SOC 2/APPIへの対応状況を公開しています。
実績としては、コールセンターとAI議事録の領域で1日13,000〜15,000時間規模の商用利用をいただいています。公開事例としてはCloopen社のクラウドCTI「SimpleConnect」での採用事例のほか、三通テレコムサービス社の「クラコールPBX/AI通話メモ」があり、導入事例の一覧でも公開しています。
向いている用途と、他社も検討したい用途
向くケース:日本語の通話録音・会議録画の書き起こしを自社プロダクトに組み込み、円建てで原価を固定したい場合。長時間ファイルを分割せずに扱いたい場合。オンプレミス要件はあるがGPUサーバーの予算を確保しづらい場合。Web会議・電話・メールでの初期技術支援を無償で提供しているため、評価工数を確保しづらいチームにもご利用いただいています。
向かないケース:対応言語は日本語・英語・中国語に絞っているため、多言語展開が主目的であればSpeechmaticsやElevenLabsなど対応言語数の多いサービスのほうが適しています。また、バッチ単価だけを最優先するならSpeechmatics Melia 1(約19円/時)のほうが安く、グローバルプラットフォーマーと比べると弊社の知名度は高くありません。医療・金融の領域特化モデルが精度の決め手になる案件では、AmiVoiceの専用エンジンが有力な選択肢になります。
用途別に見る、優先すべき比較ポイント
 用途から絞る、文字起こしAPIの選定フロー
AI議事録・会議支援:長時間音声と複数話者への対応
長時間ファイルを扱うためファイル上限が最初の足切りになります。OpenAIの25MB制限は分割実装が必要で、ElevenLabs(1GB/4.5時間)やDolphinVoice(音声1GB・動画2GB・5時間)は分割せずに投げられます。話者数上限(ElevenLabs 32話者、Amazon Transcribe 30話者)と、1時間音声が何分で返るかの実測も比較項目に入れてください。
通話録音の分析:専門用語と大量処理のコスト
2チャンネル録音が取れるならチャンネル分離を使うのが確実です。日本語の専門用語辞書と、大量処理時の単価が焦点になります。円建てのサービスで比べるならDolphinVoice(22円/時)とAmiVoice(79.2円/時〜)、ドル建てを許容するならSpeechmatics(約19円/時)とAssemblyAI(約24円/時)が同じ価格帯に並びます。
動画の字幕制作:タイムスタンプと多言語対応
単語・セグメント単位のタイムスタンプが必須です。OpenAIの主力モデルはタイムスタンプ非対応(レガシーのwhisper-1のみ)なので注意してください。多言語展開があるならSpeechmaticsやElevenLabsの対応言語数が効きます。
医療・金融・自治体:データを外部に出さない構成
候補はAzureコンテナ、Deepgram(Enterprise)、Speechmatics、AmiVoice API Private、NTTテクノクロス SpeechRec、DolphinVoiceに絞られます。領域特化モデルが必要ならAmiVoiceの医療・金融エンジン、Deepgramの Nova-3 Medical/Pharma、SpeechmaticsのOak 1 Medicalが選択肢です。ここでもGPU要否が総コストを大きく左右します。
コスト重視:為替と追加料金を含めた総額
Speechmatics Melia 1(約19円/時)、DolphinVoice標準版(22円/時・税込)、AssemblyAI Universal-2(約24円/時)、Google Dynamic Batch(約28円/時)、OpenAI gpt-4o-mini-transcribe(約28円/時)が同じ価格帯です。ドル建てのサービスは為替が原価に影響するため、円建てで固定したいかどうかが判断の分かれ目になります。
導入前に確認したい5つの項目
1. 実際の音声で認識精度を確かめる
デモ音声ではなく実際の通話・会議録音を最低30分、できれば2時間分。ノイズが多いもの、話者が重なるもの、専門用語が頻出するものを混ぜ、人手による正解テキストも用意します。
2. 長時間ファイルの上限と処理時間を測る
ファイル上限、タイムアウト、処理時間を実測します。ここで分割実装の要否が決まり、工数見積りが変わります。
3. カスタム辞書による改善を確かめる
改善幅はサービスによって大きく異なります。自社の固有名詞リストが登録語数の上限に収まるかも同時に確認します。
4. 必要な機能を含めて月額費用を試算する
話者分離・タイムスタンプ・PII削除など必要なオプションを全部足して計算します。ドル建てなら想定為替を±10%動かしたシナリオ、プロモ価格のサービスは通常価格に戻った場合の試算も併記しておくと安全です。
5. 法務・情報システム部門とデータの扱いを確認する
学習利用の可否、保持期間、オプトアウト手続き、保管場所(国内/海外)を整理し、選定の最終段階ではなく初期段階で回します。ここで差し戻しが起きると技術検証がすべて無駄になります。
文字起こしAPIのよくある質問
文字起こしAPIと音声認識APIは何が違いますか?
技術的には同じものです。実務では、録音済みファイルをまとめて処理するバッチ用途を「文字起こしAPI」、通話中にその場でテキスト化する用途を「音声認識API」「リアルタイムSTT」と呼び分けることが多いです。同じサービスでもバッチとリアルタイムで単価が1.5倍から3倍変わるため、自社の用途がどちらかを先に決めてください。
日本語の認識精度はどう比較すればよいですか?
日本語に限定した公式のWERを公開しているベンダーは、各社の公開ページを確認した範囲では見当たりませんでした。各社が掲げる「業界最高精度」は主に英語ベンチマークに基づく表現です。精度は録音品質、マイク、ノイズ、話者、専門用語の量で大きく変動するため、実データで測る以外に信頼できる比較方法はない、というのが弊社の見解です。
2時間の会議録画をそのまま投げられますか?
サービスによります。ElevenLabsは1GB/4.5時間、弊社のDolphinVoiceは音声1GB・動画2GB・長さ5時間まで対応しています。一方OpenAIはファイル上限25MBのため、分割と結合の実装が必要です。長時間ファイルを扱う前提なら、この制約を最初に確認してください。
話者分離は追加料金がかかりますか?
サービスによります。AssemblyAIは事前録音で$0.02/時、ストリーミングで$0.12/時の追加課金、ElevenLabsの話者ロール判定は10%加算です。Amazon TranscribeやSpeechmaticsは基本料金に含まれます。2チャンネル録音が可能ならチャンネル分離のほうが精度・コストとも有利になることが多いです。
無料で試すには、何から始めればよいですか?
無料枠のあるサービスを2〜3社選び、同じ音声ファイルを投げて結果を比較するのが最短です。AssemblyAI(事前録音185時間)、Deepgram($200クレジット)、Speechmatics($100クレジット)、DolphinVoice(毎月600分)、AmiVoice(各エンジン毎月60分)などに無料枠があります。
まとめ:要件で候補を絞り、実際の音声で比較する
2026年10月時点の文字起こしAPI選びを整理すると、次のようになります。
- バッチ単価を1時間換算・通貨・税・オプション込みで揃えて比較する。 基本単価だけの比較は必ずずれます。ドル建てサービスは為替が原価に直結し、プロモ価格のサービスは通常価格での試算も必要です。
- 日本語対応はモデル単位で確認する。 AssemblyAIのように、同じベンダー内でも廉価モデルだけ日本語非対応というケースがあります。
- ファイル上限と処理速度が実装工数を左右する。 OpenAIの25MB制限と、1GB規模を受け付けるサービスとでは設計が大きく変わります。
- 精度は実データで測る以外にない。 日本語のWERを公開しているベンダーは確認できませんでした。これは弊社も含めた業界共通の状況です。
- データポリシーは選定の初期段階で法務・情シスに回す。 Amazon Transcribeのようにデフォルトで学習利用される設計もあります。
- オンプレミス要件があるなら候補は6社程度に絞られ、GPU要否が総コストを左右する。
最後に弊社のサービスについて改めて書きます。DolphinVoiceは、録音ファイル書き起こしを標準版22円/時・急速版66円/時、リアルタイム音声認識を66円/時で提供している国産の文字起こしAPIです。すべて税込・円建てで料金ページに公開しており、月額固定費はありません。音声1GB・動画2GB・長さ5時間までのファイルに対応し、ログ保存の有無で単価は変わりません。ISO 27001/SOC 2/APPIに対応し、CPU中心アーキテクチャによるオンプレミス構成にも対応しています。実際の採用例は導入事例をご覧ください。
一方で、多言語展開が主目的の場合や、医療・金融の領域特化モデルが精度の決め手になる案件では、他社のほうが適していると考えています。そのうえで候補に入れていただけるようでしたら、毎月600分の無料枠から検証を始められます。オンラインのプレイグラウンドで実際の音声を投げて結果を確かめていただくこともできますし、要件の詰めが必要であればお問い合わせからご相談ください。Web会議・電話・メールによる初期技術支援は無償で提供しています。
文字起こしAPIは、一度組み込むと差し替えコストが高くつく技術部品です。2026年後半は新モデルの投入と値下げが相次いだ時期でもあります。カタログスペックではなく実データで、複数社を横並びで検証してから決めていただくのが確実です。
本記事の料金・仕様は2026年10月時点で各社公式サイトに掲載されていた内容に基づきます。ドル建て料金の円換算はドル円158円で計算した参考値です。海外ベンダーは米ドル・税抜、国内ベンダーは円・税込表示が中心であるため、実際の比較にあたっては各社の最新の公式情報をご確認ください。
記事を共有
もっと読む
音読の先へ:英語発音評価の応用問題形式を解説
DolphinSOE の英語発音評価で使える11種類の応用問題形式を解説。質疑応答、リテリング、暗唱、自由発話の採点方法・音声の上限・API パラメータを比較し、用途に合う形式を選べます。
ASRの書き起こし精度:80%と98%の差を生む、モデル以外の4つの要因
収音機器、録音環境、マイクとの距離、話者の特徴から、音声認識の書き起こし精度を左右する要因を整理。ホットワード、話者分離、単語単位の信頼度、オフライン書き起こしの活用法を紹介します。
10分で導入:発音評価 Android SDK を組み込む
テスト認証情報の取得と AAR の導入から、DolphinSOE の初期化、録音・ファイル評価、結果コールバックまでを Android Demo で確認します。