
「リアルタイム」は本当にリアルタイムか?純粋ストリーミングと擬似ストリーミングの違い
同じ「リアルタイム音声認識API」でも、発話中に文字が出る方式と、文末まで待つ方式があります。返却タイミング・接続方式・中間結果から純粋ストリーミングと擬似ストリーミングを比較します。
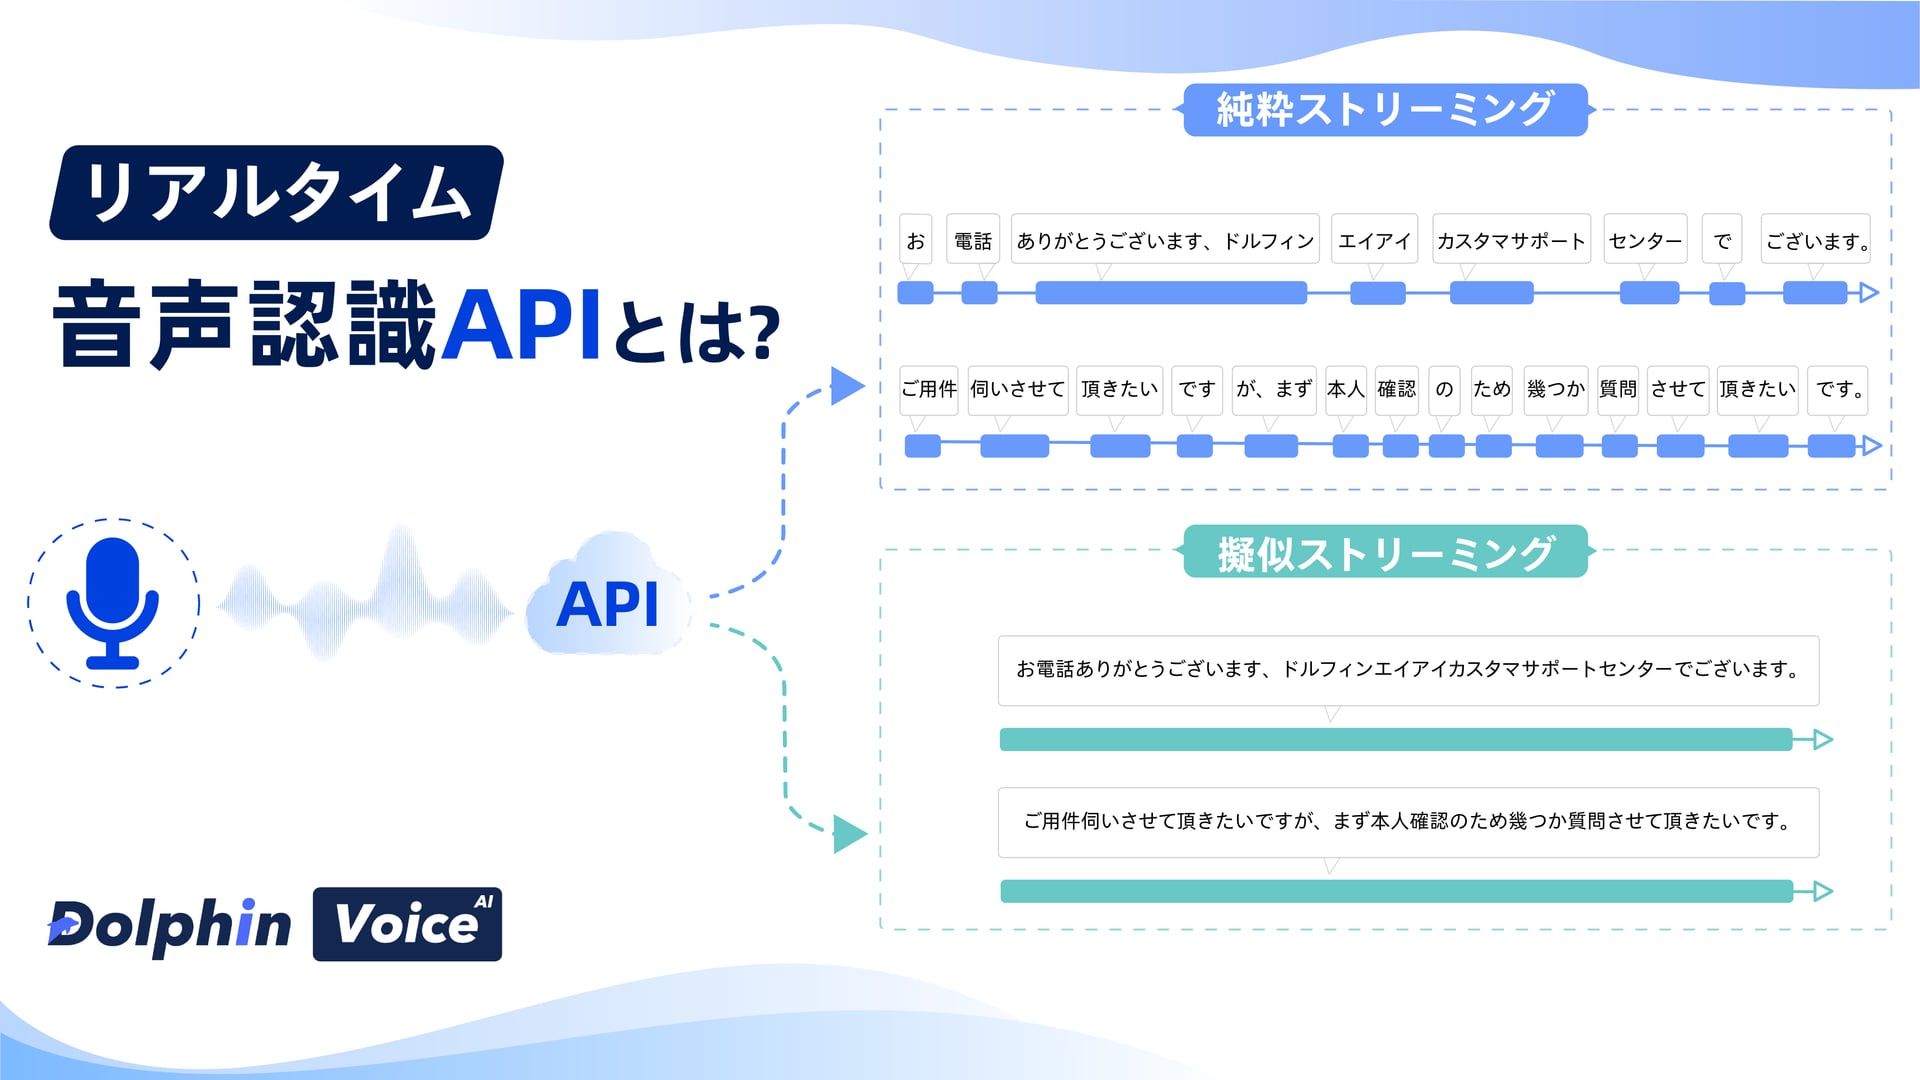
製品ページに「ストリーミング対応」と書かれていれば、話すそばから文字が出ると思うかもしれません。ところが実際には、発話中は何も表示されず、一文が終わった瞬間に全文が現れるサービスもあります。
これは数百ミリ秒の性能差ではなく、結果を返す仕組みそのものの違いです。字幕、コンプライアンス監視、Voice Agentでは、発話中に文字が出るかどうかが体験を左右します。
先に結論
純粋ストリーミングは発話中に中間結果を継続して返します。擬似ストリーミングは通常、一文が終わってから完成したテキストを返します。リアルタイム介入が必要なら、「streaming」という表記より、文字がいつ出始めるかを確認してください。
 DolphinVoiceの活用シーン・機能・価格
違いは「少し速いか」ではなく、文字がいつ返るか
音声認識APIは、マイク・電話・ライブ配信の音声を認識エンジンへ送り、テキストをアプリへ返します。どちらの方式も音声を継続的に受け取れますが、テキストを返すタイミングは大きく異なります。
 DolphinVoiceリアルタイム音声認識デモ
純粋ストリーミング:話しながら返す
WebSocketなどの永続接続を保ち、数十ミリ秒単位の音声を送り続けます。エンジンは中間結果を先に返し、文末で確定結果へ切り替えます。
擬似ストリーミング:一文の終わりを待つ
音声を分割して送るか一定間隔でリクエストし、文末を検出してから全文を返します。実装しやすく、短い音声コマンドや事後確認には十分な場合がありますが、発話が長いほど待ち時間が目立ちます。
 純粋ストリーミングと擬似ストリーミングの比較
2つの方式を比較する
| 比較項目 | 従来の擬似ストリーミング | 純粋ストリーミング |
|---|---|---|
| 文字が出るタイミング | 一文が終わってから | 話している最中 |
| 返却単位 | 文単位でまとめて | 文字・単語単位で逐次 |
| 接続方式 | HTTPの断続接続 | WebSocketの永続接続 |
| 中間結果 | なし | あり(interim / final) |
| リアルタイム介入 | 難しい | 可能 |
| 実装難易度 | 比較的やさしい | やや高度 |
本当の純粋ストリーミングを見分ける3問
「リアルタイム」「ストリーミング」という言葉だけで判断せず、次の3点を確認します。
本当の純粋ストリーミングを見分ける3問
1: 話している最中に文字が出るか。出なければ擬似ストリーミングの可能性が高いです。
2: 中間結果が継続して返るか。確定結果しかない場合、純粋ストリーミングの体験にはなりません。
3: WebSocketなどの永続接続か。リクエストごとに切断する方式は擬似ストリーミングに近いです。
DolphinVoiceが実現する純粋ストリーミング
DolphinVoiceはWebSocketの永続接続で音声を受け取り、発話中から文字を逐次表示します。認識性能に加え、同時接続や実運用に必要な機能を備え、既存システムやアプリへ組み込めます。
話しながら文字が出る
文字・単語単位で逐次返却し、中間結果から確定結果へ滑らかに切り替えます。
低遅延処理
音声フレーム処理は0.5msレベル、文末確定は約800ms、初回応答は約1000ms、RTFは0.3以下です。
高い同時処理数
1つのAPIキーで最大3000の同時接続に対応します。
単語単位の話者ラベル
発言者を単語単位で記録し、誰が何を話したかを保ちます。
実運用機能
最大20000件のhotwords、フィラーワード除去、correction_words、ITNに対応します。
時間課金
価格は1時間あたり72円からで、利用コストを見積もりやすくなっています。
技術スペック
| 項目 | スペック |
|---|---|
| 方式 | 純粋ストリーミング(WebSocket永続接続) |
| 処理遅延 | 0.5ms(音声フレーム) |
| 文末確定遅延 | 約800ms |
| 初回応答 | 約1000ms |
| RTF | 0.3以下 |
| 同時接続数 | 最大3000 |
| 連続稼働 | 最大37時間 |
| 文字誤り率(CER) | 5〜10% |
| 単語登録上限 | 最大20000件 |
| 価格 | 72円/時間〜 |
「文字を待てない」5つのシーン
純粋ストリーミングの価値は、一文の終わりを待てない現場で最も明確になります。
Before: 通話終了後に書き起こすため、品質確認や指導は事後になります。
After: 通話をリアルタイムでテキスト化し、危険・禁止表現を即時検知します。
ポイント: 問題が広がる前にスーパーバイザーが介入できます。
Before: 字幕を後から作成するため、ライブ視聴者に情報が届きません。
After: 話している最中に字幕が表示されます。
ポイント: 聴覚障害のある視聴者や多言語ユーザーへその場で情報を届け、字幕遅延による離脱を抑えます。
Before: 発話全体を待ってから応答を準備するため、会話に不自然な間が生まれます。
After: 発話中から内容を捉え、意図判断やフィードバックを準備できます。
ポイント: ターン制御が自然になり、人同士に近い対話を実現できます。
Before: 会議後に録音を送り、議事録を数時間待ちます。
After: 会議中にテキストを生成し、単語単位の話者ラベルを付けます。
ポイント: 終了直後に共有でき、決定事項の抜けもその場で補えます。
Before: 通話を事後にサンプリングし、問題のある会話を見落とす可能性があります。
After: 全通話をリアルタイムで監視し、必須案内や禁止表現を即時確認します。
ポイント: 抜き取りから全量監査へ広げ、判定ログを監査証跡として残せます。
選定で最後に見るべきこと
短い音声コマンドや事後確認なら、擬似ストリーミングで十分な場合があります。字幕同期、即時アラート、自然な対話が必要なら、発話中に文字が出続けるかを確認してください。方式の優劣ではなく、結果が必要になるタイミングとの適合が重要です。
「リアルタイム」を実際に確かめる
無料トライアルで、中間結果が確定結果へ変わる流れを確認できます。
記事を共有
もっと読む
子どもの英語発音評価に専用のKidsモデルが必要な理由
子どもの英語発音評価にKidsモデルが必要な理由を解説。音響特性の違い、採点の校正、DolphinSOEの対応形式と切り替え方法を紹介します。
26,000件の診療記録のほぼすべてに捏造内容:Whisperのハルシネーションの構造的リスクと商用対策
Whisperはなぜ無音区間で文全体を捏造するのでしょうか。APの調査報道とコーネル大学の研究をもとに、LLMデコーダーのハルシネーションの原因、四つの商用場面での代償、後処理では解決できない理由と、実践できる無音区間のテスト項目を解説します。
音素から段落まで、英語発音評価の基本問題形式を一度に解説
DolphinSOEのphoneme、word、sentence、chapter、誤り検出形式はどう選ぶべきか。評価粒度、時間上限、取得できるスコア、用途を比較して解説します。