
26,000件の診療記録のほぼすべてに捏造内容:Whisperのハルシネーションの構造的リスクと商用対策
Whisperはなぜ無音区間で文全体を捏造するのでしょうか。APの調査報道とコーネル大学の研究をもとに、LLMデコーダーのハルシネーションの原因、四つの商用場面での代償、後処理では解決できない理由と、実践できる無音区間のテスト項目を解説します。
TL;DR
- ハルシネーションはどれほど深刻か:APの調査では、Whisperを使って生成された約26,000件の診療記録のほぼすべてに捏造内容が含まれていました。コーネル大学の研究では、約1%の書き起こしに音声に存在しない文全体のハルシネーションがあり、その38%に明示的な有害性があると定量化されています。
- 原因はアーキテクチャにある:Whisperのデコーダーは本質的に言語モデルであり、無音、ノイズ、間に遭遇すると「最も人間らしく聞こえる内容を補完する」傾向があります。これは確率的生成に固有の挙動であり、修正できるバグではありません。
- 解決策もアーキテクチャにある:DolphinVoiceは非LLMデコーダー(純粋な音響マッピングで、テキスト生成機構を持たない方式)を採用し、最初からハルシネーションを生成しません。無音区間では空のテキストを返すため、診療記録、コールセンターの品質確認、コンプライアンス対応の録音、アクセシビリティ向け字幕などに安心して導入できます。構造の詳細は第4節をご覧ください。
- 後処理では解決できない:LLMでハルシネーションを確認・除去するのは「ハルシネーションでハルシネーションを調べる」ことに等しく、コストは倍増し、遅延も加算されます。
- 検証は簡単:無音区間を含む音声で試せばよいのです。ハルシネーションゼロのエンジンは、無音区間で空のテキストを返します。テスト項目は第5節にまとめています。
はじめに:捏造された診療記録
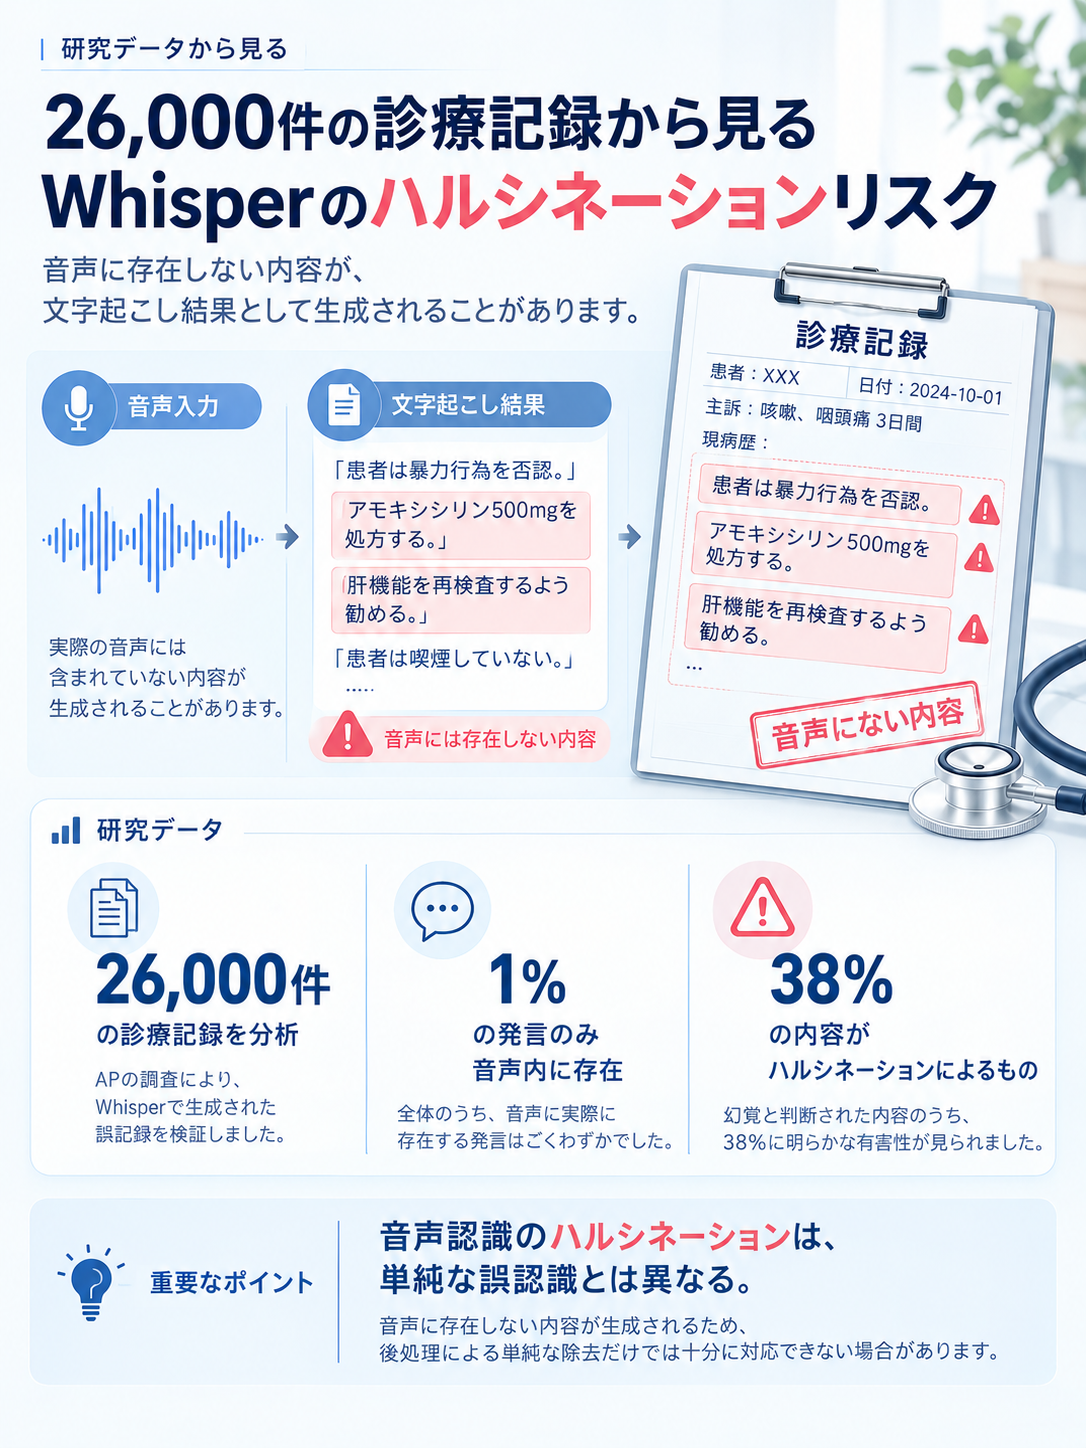
2024年10月、AP通信は、音声認識業界で暗黙の了解とされていた問題を表に出す調査報道を発表しました。研究者が、OpenAI Whisperを基盤とする医療書き起こしツールNablaで生成された約26,000件の診療記録を調べたところ、ほぼすべてに音声に存在しない捏造内容が含まれていました。これが典型的なWhisperのハルシネーションです。音声にまったく存在しない文字が、書き起こし結果に現れます。別の研究でも、明瞭に発話された13,000件を超える音声断片から187件のハルシネーションが見つかりました。
一部の人しか使わないツールでの出来事ではありません。報道によると、ミネソタ州のMankato ClinicやChildren’s Hospital Los Angelesを含む40の医療システムと30,000人を超える臨床医がこのツールを使用し、累計で約700万回の診療を書き起こしていました。ミシガン大学のある研究者の集計では、調査した書き起こしサンプルの約8割にハルシネーションがありました。実際にはなかった薬の説明、発せられていない暴力的な発言、医師も患者も言っていない内容が、記録に書き込まれていたのです。
こうした捏造された文章が診療記録、品質確認レポート、コンプライアンス対応の録音アーカイブに入っても、誰も気づきません。「人が話した内容にしか見えない」からです。
これはバグではなく、アーキテクチャの問題です。 本記事では、Whisperがなぜ捏造するのか、商用利用でどのような代償が生じるのか、そして技術選定の責任者として書き起こしエンジンにハルシネーションがあるかをどう検証するのか、という三点を説明します。
1. Whisperはなぜ「捏造」するのか:LLMデコーダーの構造的リスク
先に結論を述べると、Whisperのハルシネーションは、そのデコーダーが本質的に言語モデルであることに由来します。
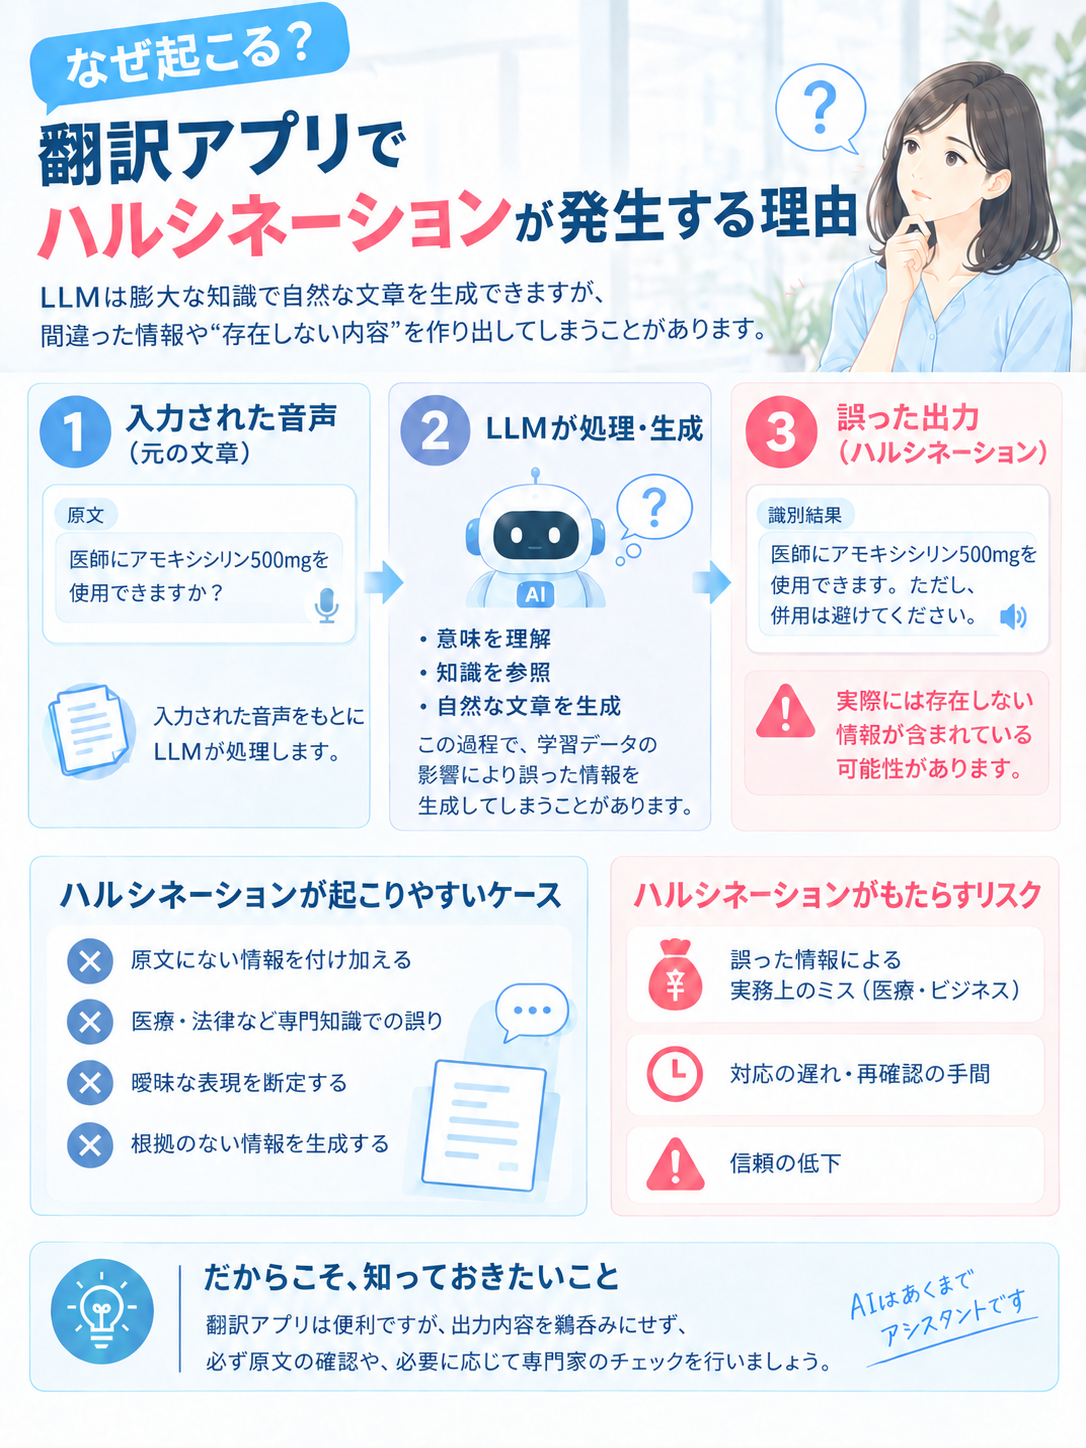
Whisperの構造は二つに分かれます。エンコーダーが音声を音響特徴に変換し、デコーダーがその特徴を文字へ「翻訳」します。重要なのは、このデコーダーが自己回帰型の言語モデルだという点です。学習中に大量の「文章の続きを作る」能力を身につけ、文字を生成するたびに「次に来る可能性が最も高い単語」を予測します。
この設計は明瞭な発話では優れた結果を出します。Whisperの認識精度は業界でも高く評価され、学術論文もその点を明確に認めています。問題は、音声に有効な発話がないときです。無音、長い間、背景ノイズ、せきの音に対して、純粋な音響システムが取るべき正しい挙動は「空のテキストを返す」ことです。そこでは何も話されていません。しかし言語モデルには、学習によって**「最も人間らしい内容を補完する」**傾向があります。「この後には通常この文が続く」というデータを大量に見てきたため、黙るべきところで話し始めてしまいます。
技術者の間では、無音区間や背景ノイズがハルシネーションの重要な誘因だと広く考えられています。ただし率直に言えば、正確な原因はいまだ完全には特定されていません。特定のバージョンを少し修正すれば解消する欠陥ではなく、確率的な言語生成に生来備わる挙動なのです。
定量化された証拠
コーネル大学の研究「Careless Whisper: Speech-to-Text Hallucination Harms」(Koeneckeら、arXiv:2402.08021)は、現時点で特に参考になる定量データを示しています。
- 約1%の書き起こしに、音声にまったく存在しない文全体のハルシネーションが含まれる:個々の単語の誤認識ではなく、文全体である点が重要です。
- ハルシネーションの38%に明示的な有害性がある:暴力的な発言、誤った関連付け(別々の人の発言を一つの文にまとめるなど)、捏造された権威的な表現です。
- 発声していない時間が長い話者ほど、ハルシネーション率が大幅に高い:研究では、失語症などの言語障害がある人々に被害が集中すると指摘されています。書き起こしの支援を最も必要とする人々が、最も高い捏造リスクを負っているのです。
OpenAI自身の立場も問題の深刻さを裏付けています。Whisperの利用ポリシーは高リスクな意思決定場面での使用を禁じ、オープンソースのモデルカードも高リスク領域での使用を推奨していません。それでも現実には、多くの医療機関が重要な業務工程に組み込んでいます。 日本でもITmediaなどの主要なテクノロジーメディアがこの問題を取り上げています。日本企業で技術選定を担当しているなら、検討の場に挙げるべき問題です。
重要な視点:ハルシネーションは「最も信じやすい」誤り
過小評価されやすい事実があります。ハルシネーションはランダムな誤りではなく、モデルが「最も人間らしい」方向に間違える現象です。 認識ミスには、一目で分かる文字化けや誤字がよくあります。一方、ハルシネーションが生成するのは、文法が整い、意味がもっともらしく、語調も自然な完全な文です。とりわけ信頼できそうに見えるからこそ、危険も大きくなります。後続の確認担当者、検索システム、LLM分析パイプラインは、いずれも「書き起こしは信頼できる一次記録」という前提で動きます。ハルシネーションは、まさにその信頼につけ込みます。
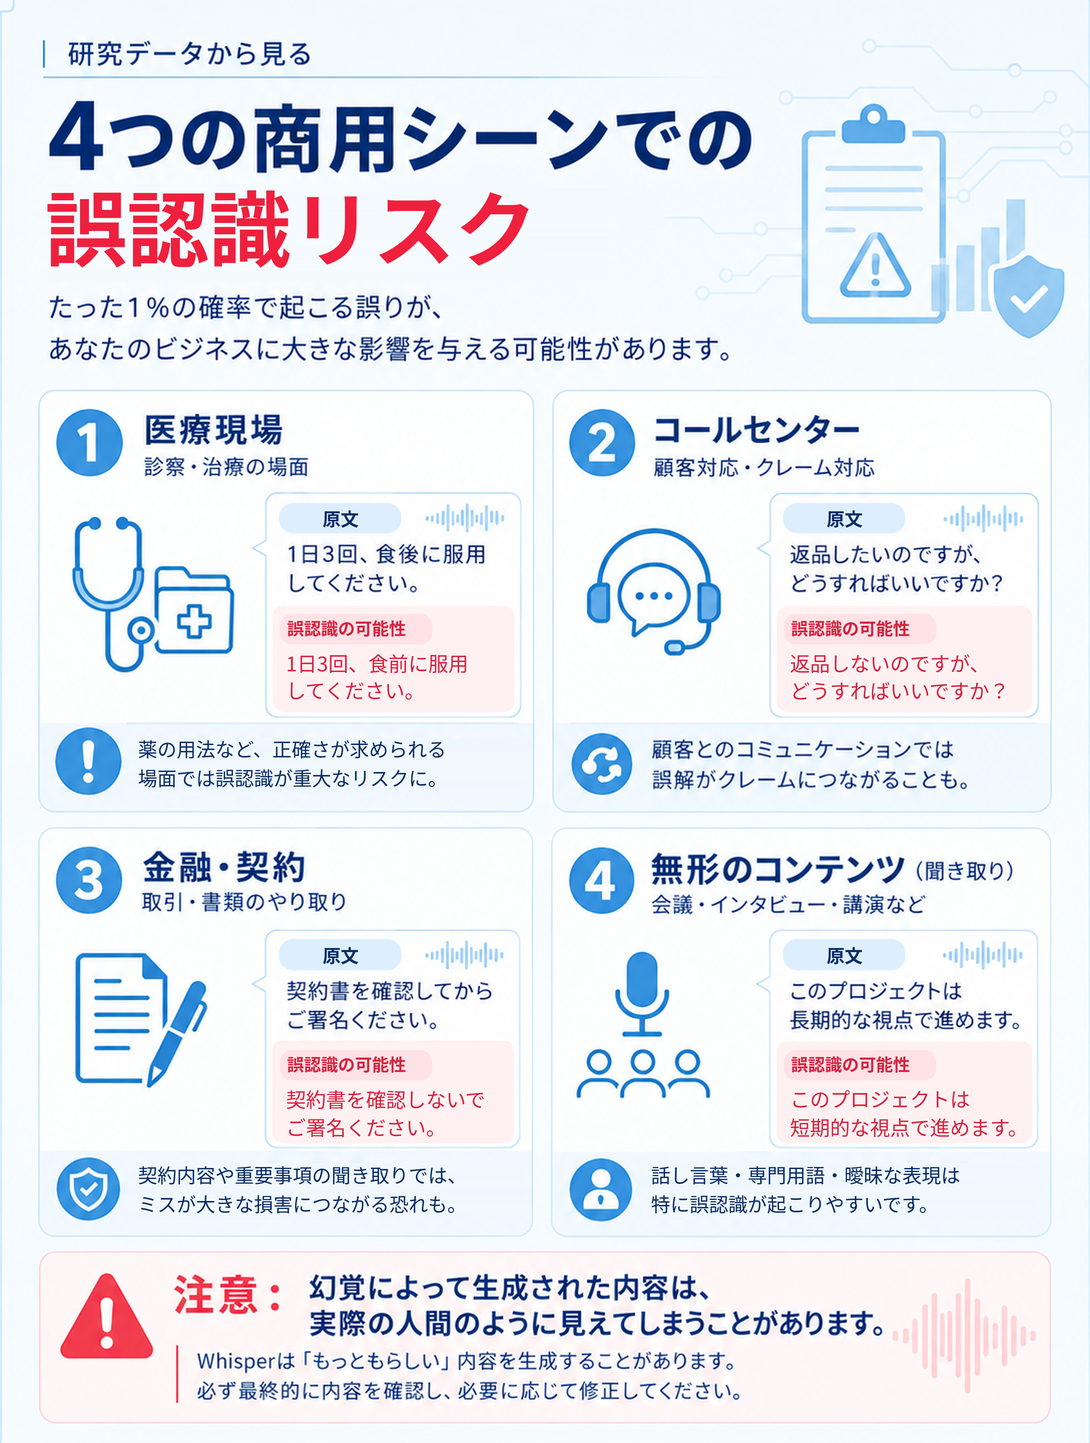
2. 商用場面でのハルシネーションの代償:医療、コールセンター、金融、アクセシビリティ向け字幕
「ハルシネーション率1%」を抽象的に議論しても意味はありません。重要なのは、自社の業務で何が起こるかです。
| 場面 | ハルシネーションの形態 | 業務への影響 |
|---|---|---|
| 診療記録 | 存在しない医師の指示、薬の説明、患者の発言を捏造する | その後の診療を誤らせ、医療事故や法的リスクにつながる(AP報道ではMankato Clinicなどの施設にも影響) |
| コールセンターの品質確認・コンプライアンス | 無音やノイズの区間が「顧客の発言」として補完される | 捏造内容が実際の会話として品質レポートや研修資料に入り、苦情の原因分析をゆがめる |
| 金融録音のコンプライアンス | 取引確認時の間が、約束を意味する文として「補完」される | 規制上求められる忠実な記録に捏造が入り、技術的な不備ではなくコンプライアンス上の事故になる |
| 聴覚障害者向け字幕 | 発話のない区間に字幕が表示される | 利用者はどこが捏造なのかをまったく識別できない。アクセシビリティの場面で最も非対称なリスクとなる |
四つ目の場面は特に強調すべきです。Whisperは聴覚障害者向け字幕の生成に広く使われています。聞こえる人なら音声と字幕を比べて「ここは誰も話していない」と気づけますが、聴覚障害のある利用者にはそれができません。受け取る捏造された文章の一つひとつが、自分では確認できない「事実」になります。
コールセンターについても補足します。顧客対応の会話には、顧客が考える時間、調べ物、背景ノイズなどによる無音が多く含まれます。そこはまさにハルシネーションが起こりやすい部分です。品質確認システムの学習データやオペレーターの研修資料に、捏造された「顧客の発言」が混ざれば、誤ったデータに基づく運用上の判断がことごとく体系的にゆがみます。しかも、誰も出発点の誤りに気づきません。
3. なぜ「後処理による除去」ではハルシネーションを解決できないのか
多くのチームは、まず書き起こしの後にLLMを接続し、確認してハルシネーションを取り除こうと考えます。しかし、この方法では解決できません。理由は三つあります。
- ハルシネーションでハルシネーションを調べている。 確認するLLM自体も言語モデルであり、同じハルシネーションの問題を持ちます。さらに悪いことに、「文法が整い、意味ももっともらしい」捏造文を前にしても、比較できる音声の原情報(ground truth)がありません。その文が実際に話されたかは判断できず、「人の言葉らしいか」しか判断できません。そしてハルシネーションこそが、最も人の言葉らしいのです。
- コストが倍増する。 音声1時間あたりの書き起こし費用に加えて、LLMをもう一度呼び出すトークン費用がかかります。毎日数千時間の音声を処理する業務では、推論の請求額がそのまま2倍になります。
- 遅延が加算される。 顧客対応のリアルタイム品質確認やライブ字幕には低遅延が求められます。LLMによる確認工程を直列につなぐと、処理経路が大幅に長くなります。
結論として、ハルシネーションはデコーダーの段階で解決すべきであり、下流の修繕には頼れません。 アーキテクチャの問題には、アーキテクチャで答えるしかありません。DolphinVoiceが設計当初から非LLMデコーダーを選んだのも、そのためです。ハルシネーションの除去が得意なのではなく、最初から生成しないのです。
4. ハルシネーションゼロの構造:最初から捏造しない
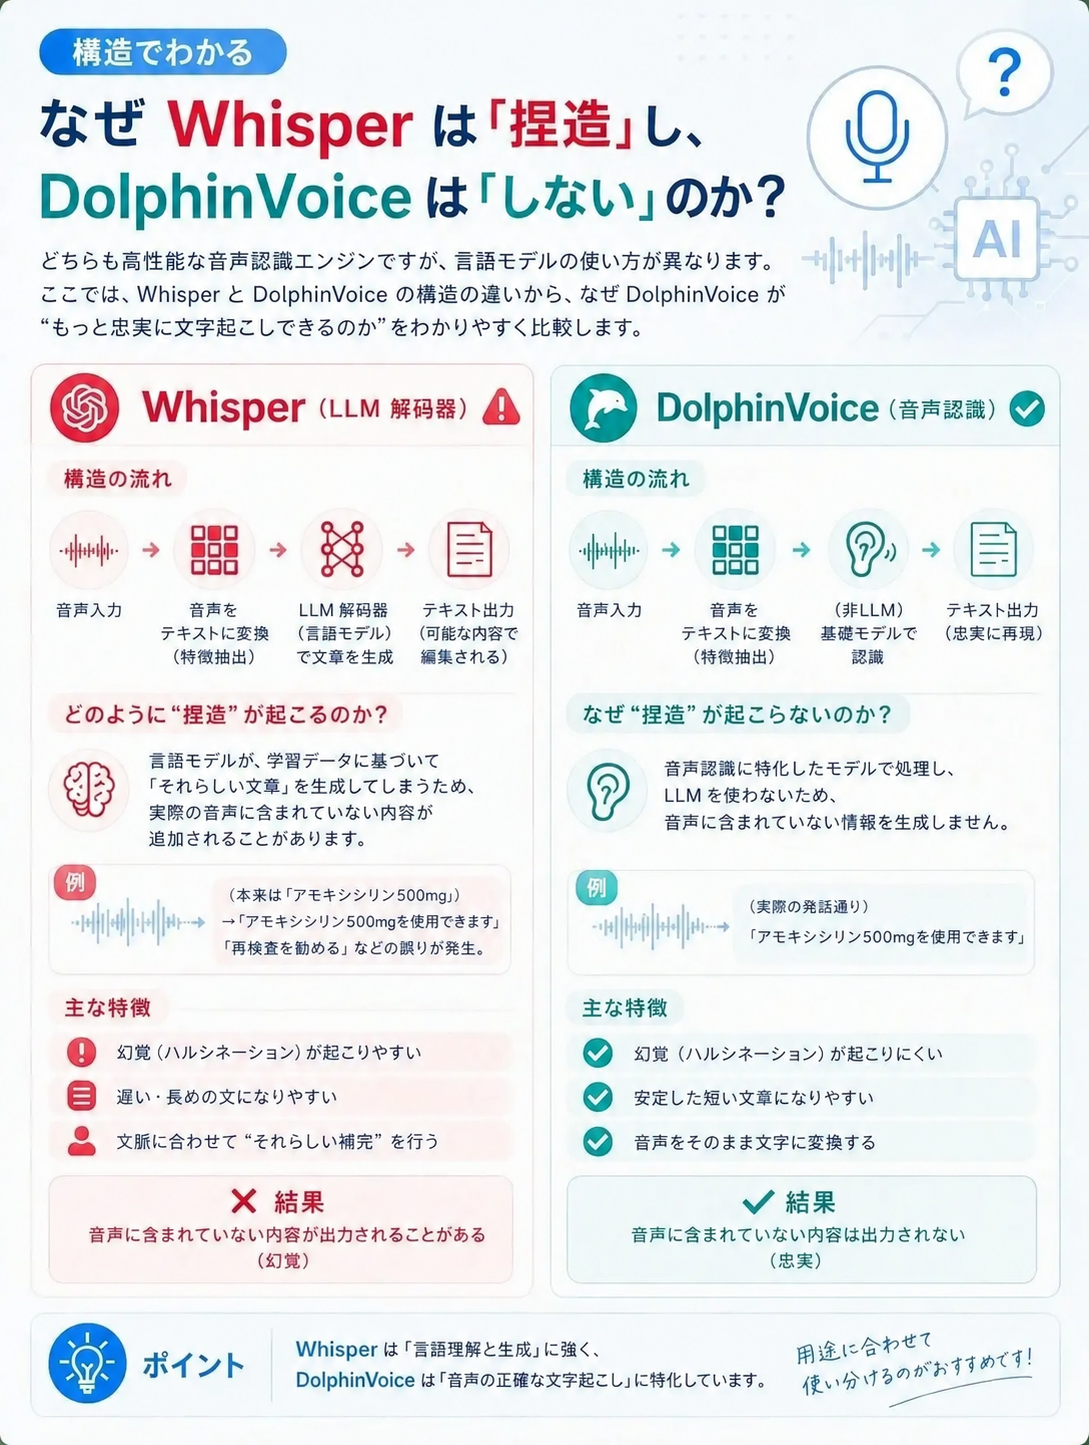
DolphinVoiceの書き起こしエンジンは、LLMデコーダーを使わない純粋な音響モデルの構造を採用しています。ハルシネーションに関する本質的な違いは次のとおりです。
| LLMデコーダー(Whisperなど) | 音響デコーダー(DolphinVoice) | |
|---|---|---|
| 生成の仕組み | 言語モデルの確率に基づき「最もありそうな文字」を予測する | 音響特徴の対応付けに基づき、音声にある内容だけを出力する |
| 無音区間での挙動 | 学習上の傾向から、もっともらしい文字を「補完」する | 空のテキストを返す。発話がなければ文字もない |
| ハルシネーションの発生源 | 構造的に存在し、緩和しかできない | 構造上、生成する経路が存在しない |
| 適した用途 | 明瞭な音声を扱う、重要度の低い場面 | 「忠実性」が必須となる商用場面 |
ここでいうハルシネーションゼロの意味は具体的です。音声にない発話は出力に現れず、無音区間では空のテキストを返します。 これは構造の性質であり、後処理による補完策には依存しません。
ハルシネーションだけ解決すれば十分だと言っているわけではありません。商用エンジンであるDolphinVoiceは、現在1日あたり15,000時間以上を処理し、8kHzのコールセンター音声でWER約5%、リアルタイムの最初の文字出力まで約1秒、オフラインの書き起こしは音声1時間あたり約58秒(話者分離を含む)です。リアルタイム話者分離、ホットワードのカスタマイズ、ITN、フィラーワードとセンシティブワードのフィルタリングも標準搭載しています。インターフェースの詳細は開発者ドキュメント、価格はAPI料金ページで確認できます。CPU推論の構造も特徴です。1コアで同時1ストリームに対応し、GPUを必要としません。そのためオンプレミス導入でもハルシネーションゼロの能力をそのまま実現でき、クラウドGPUの供給に合わせる必要がありません。
5. 選定時に「ハルシネーションゼロ」を検証する方法:導入担当者向けテスト項目
最終的にどのベンダーを選ぶにしても、POCの段階でハルシネーションのテストを受け入れ基準に入れることをお勧めします。方法は簡単で、特別な機器は必要ありません。
ステップ1:四種類の「難しい音声」を、それぞれ10件程度用意します。
- 純粋な無音区間。通常の二つの発話の間に、3秒以上の連続した無音を挟んだものも含めます。
- ホワイトノイズ/ピンクノイズを背景とする短い発話。
- 非発話の人声:せき、せき払い、笑い声、「ええと…」のような長いフィラーワード。
- 通常と異なる話速と長い間:意図的にゆっくり話す音声、文と文の間が5秒以上空く独話。
ステップ2:書き起こして集計し、無音区間とノイズ区間の位置に文字が出ていないか確認します。 波形図と人手で照合してもよいですし、ベンダーにタイムスタンプ付きの出力を求め、区間ごとに確認しても構いません。
ステップ3:出力のタイムスタンプの整合性を確認します。 ハルシネーションゼロのエンジンでは、文字のタイムスタンプが有効な発話区間の中に厳密に収まるはずです。聞き取れる発話がない時間区間に文字が付いていれば、それはハルシネーションです。
判定基準としてお勧めするのは、「ハルシネーション率がX%未満か」ではなく、「無音区間で空のテキストを返すか」です。前者は運やサンプルの偏りでよく見せられますが、後者は構造上の挙動であり、測定されたものがそのまま実態です。
このテストは、私たちを含むどのベンダーにも適用できます。自社の構造に自信を持つベンダーなら、無音区間を含む音声でのテストを歓迎するはずです。DolphinVoice Playgroundに無音区間を含む音声を直接アップロードすることもできます。リアルタイムとオフラインのどちらでも、無音区間での出力動作をすぐに確認できます。
結論
一文でまとめると、WhisperのハルシネーションはLLMデコーダーの構造的リスクです。約1%の書き起こしに文全体のハルシネーションが含まれ、その38%に明示的な有害性があり、後処理では解決できず、構造で解決するしかありません。 検証方法も一文です。無音区間を含む音声で試せば、ハルシネーションゼロのエンジンは無音区間で空のテキストを返します。
おわりに:書き起こしツールの第一の責務は「忠実であること」
冒頭の26,000件の診療記録に戻りましょう。音声認識ツールの第一の責務は忠実に記録することです。その最低限の基準において、捏造は認識漏れよりはるかに危険です。認識漏れは能力の限界の問題ですが、捏造は信頼性をゼロにする問題です。品質確認レポート、コンプライアンス対応の録音、診療記録に「真実にしか見えない」偽の内容を混ぜるシステムは、精度がどれほど高くても重要な処理経路に入れるべきではありません。
Whisper系の仕組みを評価中、あるいはすでに利用しているなら、まず第5節のセルフテストを実施し、自社の無音区間がどのように書き起こされるか確認してください。Playgroundに音声を直接アップロードして試すか、クイック登録から接続してテストできます。
私たち(DolphinVoiceチーム)は、ハルシネーションのセルフテストに使える無音・ノイズ区間の音声サンプルも提供できます。テスト方法については、ぜひお問い合わせください。
よくある質問(FAQ)
Whisperのハルシネーションとは何ですか?
音声にまったく存在しない文字が書き起こしに現れることです。典型例は、無音、ノイズ、せき、長い間が、文法的に自然な完全な文へと「補完」される現象です。APが調査したWhisperベースの約26,000件の診療記録には、ほぼすべてにこの種の捏造内容が含まれていました。
Whisperのハルシネーションは、どのようなときに最も起こりやすいですか?
連続した無音、背景ノイズ、非発話の人声(せき・笑い声・フィラーワード)、長い間など、音声に有効な発話がないときです。純粋な音響システムなら空のテキストを返すべきですが、LLMデコーダーは言語モデルの傾向に従って「最も人間らしい内容を補完」します。
LLMの後処理でハルシネーションを除去できますか?
信頼できる方法ではありません。確認するLLM自体が言語モデルであり、ハルシネーションでハルシネーションを調べているからです。比較する音声の原情報もないため、「人の言葉らしいか」しか判断できず、ハルシネーションこそが最も人の言葉らしく見えます。同時にコストは倍増し、遅延も加算されます。ハルシネーションはデコーダーの段階で解決しなければなりません。
書き起こしエンジンにハルシネーションがあるか、どう試せますか?
純粋な無音区間、ノイズ下の短い発話、せきや笑い声などの非発話の人声、ゆっくりした発話と長い間という四種類を用意します。書き起こした後、無音区間とノイズ区間の位置に文字が出ていないか確認してください。判定基準は「ハルシネーション率がX%未満」ではなく、「無音区間で空のテキストを返すか」です。後者は構造上の挙動であり、サンプルでよく見せることはできません。
DolphinVoiceでは、なぜこの種のハルシネーションが起こらないのですか?
DolphinVoiceはLLMデコーダーを使わない純粋な音響モデルの構造を採用し、音声にある内容だけを出力して、無音区間では空のテキストを返します。これは構造の性質であり、後処理による補完策には依存しません。現在、日本の実際の商用環境で1日あたり15,000時間以上を処理し、コールセンターや議事録など複数の業種・用途で、実運用の高い同時処理数と認識精度への要求に応えています。
データの出典
- APの調査報道(2024年10月):NablaによるWhisperベースの診療記録約26,000件の調査。
- コーネル大学の研究「Careless Whisper: Speech-to-Text Hallucination Harms」(Koeneckeら):arXiv:2402.08021。
- OpenAI Whisperの利用ポリシーおよびオープンソースのモデルカードにある高リスク場面での使用制限。
- DolphinVoiceの性能データ:dolphinvoice.ai公式サイト(2026年8月)。
記事を共有
もっと読む
音素から段落まで、英語発音評価の基本問題形式を一度に解説
DolphinSOEのphoneme、word、sentence、chapter、誤り検出形式はどう選ぶべきか。評価粒度、時間上限、取得できるスコア、用途を比較して解説します。
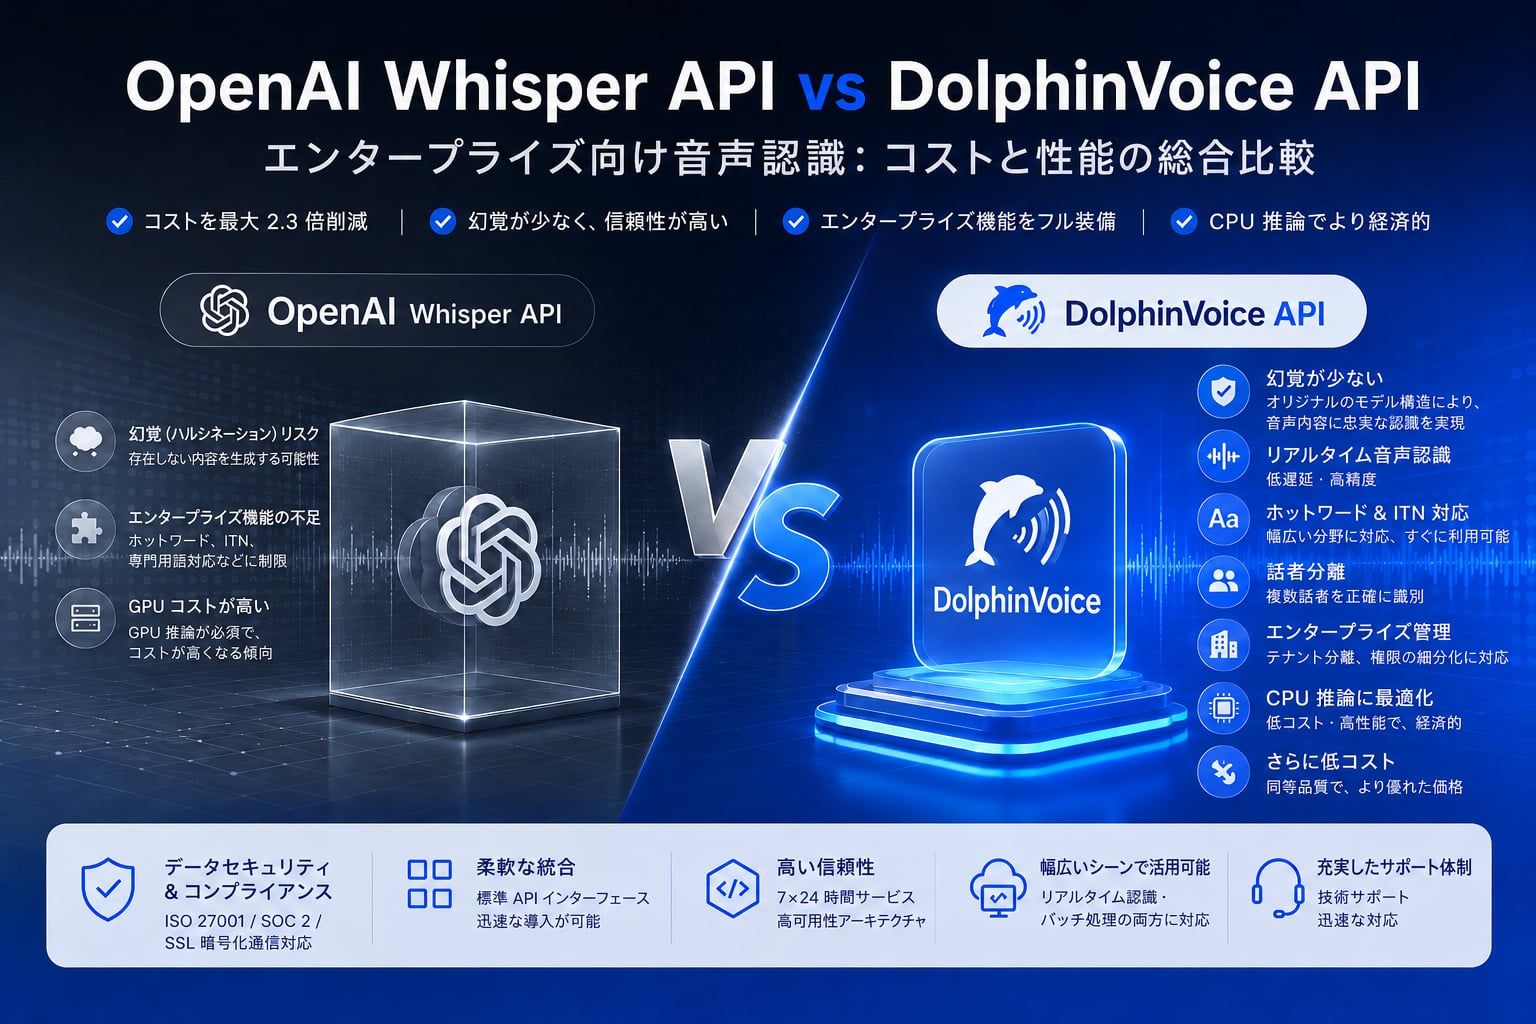
OpenAI Whisper API vs DolphinVoice API:エンタープライズ向け音声認識のコストと機能を徹底比較
OpenAI Whisper API と DolphinVoice API を、アーキテクチャ、リアルタイム・オフラインAPI料金、全込み TCO、ホットワード、話者区別、テキスト後処理、商用規模での検証まで比較します。
発音評価APIの仕組み:音声から多次元スコアまで
音声を送信してから多次元の発音スコアが返るまで、何が起こっているのか?DolphinSOE発音評価APIの処理フロー(収録・アライメント・スコアリング)を実際のレスポンス例とともに解説します。