
子どもの英語発音評価に専用のKidsモデルが必要な理由
子どもの英語発音評価にKidsモデルが必要な理由を解説。音響特性の違い、採点の校正、DolphinSOEの対応形式と切り替え方法を紹介します。
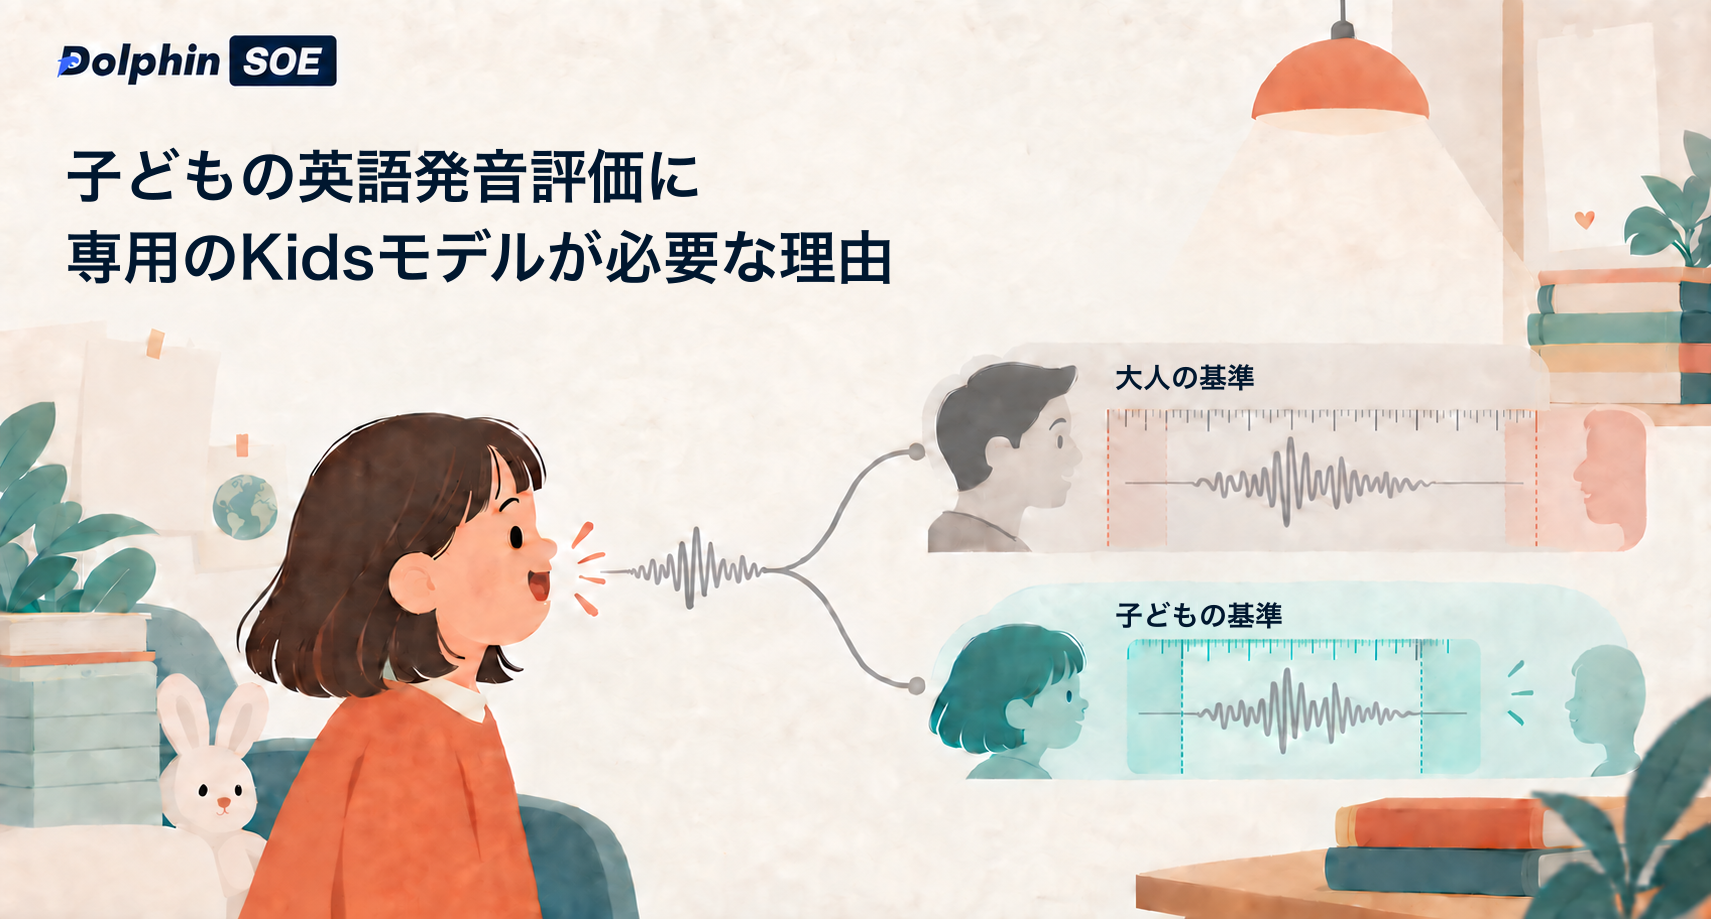
7歳の子どもが、高さ3.05メートルのバスケットゴールにシュートを放っても、なかなか入りません。だからといって、シュートが下手だとは限りません。ゴールの高さは大人を基準に決められています。子どもに合った高さに調整してこそ、その子の実力や上達が見えてきます。
 高いバスケットゴールの下に立つ子どもとバスケットボール。
子どもの英語発音評価にも、同じような問題があります。多くの発音評価エンジンは、大量の成人音声で学習した音響モデルを使っています。そのモデルで子どもを採点しても、信頼できるスコアになるとは限りません。では、ゴールを低くするように採点基準を緩めれば解決するのでしょうか。実際には、それほど単純ではありません。
前回の「音素から段落まで、英語発音評価の基本問題形式を一度に解説」では、選定時に確認すべき点として「利用者は大人か、子どもか」を挙げました。今回は、子ども向けの発音評価モデルが何を解決するのかを掘り下げます。
子どもの音声は何が違うのか
子どもは、単に「英語の発音が未熟な大人」ではありません。基本周波数、フォルマント、話速、発音の安定性には、大人との体系的な違いがあります。音声の特徴は、身体的な条件の違いによって別の分布を示します。
| 観点 | 子どもの音声の特徴 | 汎用モデルへの影響 |
|---|---|---|
| 基本周波数 F0 | 学齢期の子どもは一般に250〜400 Hzで、成人男性の約120 Hz、成人女性の約200 Hzより高い [1] | 音響モデルのフレーム単位の事後確率が全体的に低くなる |
| 声道長 | 声道が短く、フォルマント周波数が声道長におおむね対応して高くなる [1] | 母音空間が全体的にずれ、母音認識に偏りが生じる |
| 発音器官 | 発達途上にあり、/r/↔/w/、/θ/↔/s/、/l/↔/r/などの発音が安定しない [2] | replace(読み誤り)と判定される |
| 発話リズム | 間や引き伸ばしが多く、息が弱い、音量が変動する、話速が大人より遅い [3] | fluency / integrityが減点される |
 年齢層別に見た、舌位置の異なる母音の第1・第3フォルマント分布 [1]。
図からは、同じ母音でも、年齢層によってフォルマントの分布が明確に異なることが分かります。汎用モデルが学習しているのは、成人音声におけるこれらのパラメータの範囲です。入力全体がその範囲からずれると、「この音素は正しく発音されたか」という判断の信頼度も全体的に下がります。この音響的な不一致は、子どもの音声認識精度が大人より低くなりやすい根本的な要因です。
汎用モデルで起こりやすい誤判定
こうした違いにより、汎用モデルを子どもの発音評価に用いると、次のような問題が生じます。
スコアが全体的に低くなる。 音響的な不一致によって音素の事後確率が下がり、accuracy(正確さ)も低くなります。問題は、その低さが子どもの実際の発音能力を反映していないことです。頑張って練習しても、スコアに表れない場合があります。
正しく読んだ語が誤りとされる。 発達に伴う発音の違いがreplace(読み誤り)に分類され、正しく読めていてもアプリに「この単語は間違い」と表示されます。こうした指摘が続けば、自信を失いかねません。
流暢さが不当に低く評価される。 大人の話速を基準にすると、子どものfluencyは低いままになりがちです。しかし、つかえながら話すことは自然な学習過程であり、流暢さは特に成長を見守る必要がある観点です。
汎用モデルの問題は、単に採点が厳しいことではなく、採点が実力を正確に捉えていないことです。子どもの発音能力ではなく、大人の発音からどれだけ離れているかを測ってしまいます。
子ども向けのサービスでは、この問題が悪循環につながることがあります。
 低いスコア、自信の低下、練習時間の減少、上達の遅れが繰り返される循環。
この状態が続けば、利用者の離脱にもつながります。単語の問題形式を例に、同じ子どもの音声を評価したときの典型的な違いを示します。
| 評価項目 | word(汎用) | word_kids(子ども向け) | 違いが生じる理由 |
|---|---|---|---|
| overall | 62前後 | 85前後 | 音響モデルと採点曲線が異なる |
| accuracy | 明らかに低い | 妥当な範囲に戻る | 音素の事後確率を校正する |
| 単語単位のtype | replaceになりやすい | 多くがnormal | 発達に伴う違いを読み誤りと判定しなくなる |
| 音素単位のフィードバック | あり | あり | 評価の細かさは変わらない |
Kidsモデルとは
Kidsモデルは、子どもの音声データで調整した専用の音響モデルと、子どもの発音分布に合わせて校正した採点方式を組み合わせたものです。
対応する問題形式は3つで、それぞれ汎用の形式と一対一で対応しています。
| 子ども向けの形式 | 対応する汎用形式 | 音声の長さの上限 | ファイルサイズの上限 |
|---|---|---|---|
| word_kids | word | 20秒 | 1 MB |
| sentence_kids | sentence | 90秒 | 1.5 MB |
| chapter_kids | chapter | 300秒 | 10 MB |
モデル以外の、問題形式の制約、参照テキストの上限、評価項目、レスポンス構造は汎用版と同じです。
子ども向けモデルが変えるのは、採点の基準です。「成人の標準的な発音との比較」から、「同年代の子どもの発音分布との比較」へ切り替えます。単純にスコアを底上げするのではなく、公平な基準に戻すことで、子ども同士の比較や、同じ子どもの経時的な変化を捉えられるようにします。
wordからword_kidsへの切り替えでは、リクエストパラメータのmodeを1つ変更するだけです。
エンジン側では何を調整しているのか
以前の「発音評価APIの仕組み」を読んだ方は、同じ処理パイプラインに子ども向けの分岐を設けたものと考えると分かりやすいでしょう。
音響モデル。 基盤となる2つの出力ヘッドを持つLSTMの構造は変わりません。多層LSTMにfbank特徴量を入力し、その後のテキストと音素の2つの出力分岐で、1回の順伝播からテキストと音素アラインメントを得ます。子ども向けモデルで異なるのは学習データです。年齢、アクセント、録音機器の異なる子どもの朗読音声を用いて学習・適応を行います。子どもの音声でも音素の事後確率が有効に働くかどうかを左右する工程です。
採点の校正。 アラインメント後の採点曲線を、子どもの発音分布に合わせて再校正し、全体的にスコアが低くなる偏りを補正します。物差しのゼロ点を正しい位置に合わせるような調整です。
子ども向けサービスにおけるデータ保護
子どもが利用するサービスでは、データ保護も重要です。未成年者のプライバシーには、特に配慮が求められます。
DolphinSOEは、ISMSの国際規格であるISO 27001認証を含む複数の情報セキュリティ関連認証を取得し、SOC 2 Type II報告書も取得しています。通信はHTTPS/WSSで暗号化され、クラウド上のデータは東京のデータセンターに保存されます。データは日本国内で保管され、国外へ移転されません。
収集するデータは必要最小限に限定しています。SDK側では個人を特定する情報を収集せず、エンジンに送信するのは音声と評価用テキストのみです。音声はデフォルトではエンジン側に保存しません。音声のダウンロードが必要な場合は、パラメータ設定により30日間の一時保存が可能で、期限後は自動的に削除されます。データを第三者に販売・貸与することはありません。
DolphinSOEは日本市場で安定稼働しており、1日当たりの呼び出し回数は約10万回です。外国語学習アプリ、学校、学習塾などの教育機関で利用され、同時リクエストの多い実際の教育現場で継続的に検証されています。教育分野の主要顧客にも採用されています。
同じ音声で両モデルを比べる
子ども向けのサービスを開発しているなら、まず現在の評価結果を分析し、比較してみてください。実際の子どもの録音を1つ用意し、汎用モデルとKidsモデルの両方で評価して、スコアの違いを確認します。差が最も大きい評価項目は、汎用モデルがそれまで誤判定していた部分であることが多いのです。成人の音声データで学習した汎用音響モデルで子どもの音声を採点すると、発達に伴う特徴を発音の誤りとして扱ってしまい、スコアが全体的に低くなります。Kidsモデルが行うのは、採点の基準を「成人の基準」から「子どもの発音分布」へ戻すことです。
参考文献
[1] Vorperian, H. K., & Kent, R. D. (2007). Vowel acoustic space development in children: A synthesis of acoustic and anatomic data. Journal of Speech, Language, and Hearing Research, 50(6), 1510–1545.
[2] Preston, J. L., & Lee, S. (2025). The articulatory basis of phonological error patterns in childhood speech sound disorders. Frontiers in Human Neuroscience, 19, 1635096.
[3] Logan, K. J., Byrd, C. T., Mazzocchi, E. M., & Gillam, R. B. (2011). Speaking rate characteristics of elementary-school-aged children who do and do not stutter. Journal of Communication Disorders, 44(1), 130–147.
記事を共有
もっと読む
26,000件の診療記録のほぼすべてに捏造内容:Whisperのハルシネーションの構造的リスクと商用対策
Whisperはなぜ無音区間で文全体を捏造するのでしょうか。APの調査報道とコーネル大学の研究をもとに、LLMデコーダーのハルシネーションの原因、四つの商用場面での代償、後処理では解決できない理由と、実践できる無音区間のテスト項目を解説します。
音素から段落まで、英語発音評価の基本問題形式を一度に解説
DolphinSOEのphoneme、word、sentence、chapter、誤り検出形式はどう選ぶべきか。評価粒度、時間上限、取得できるスコア、用途を比較して解説します。
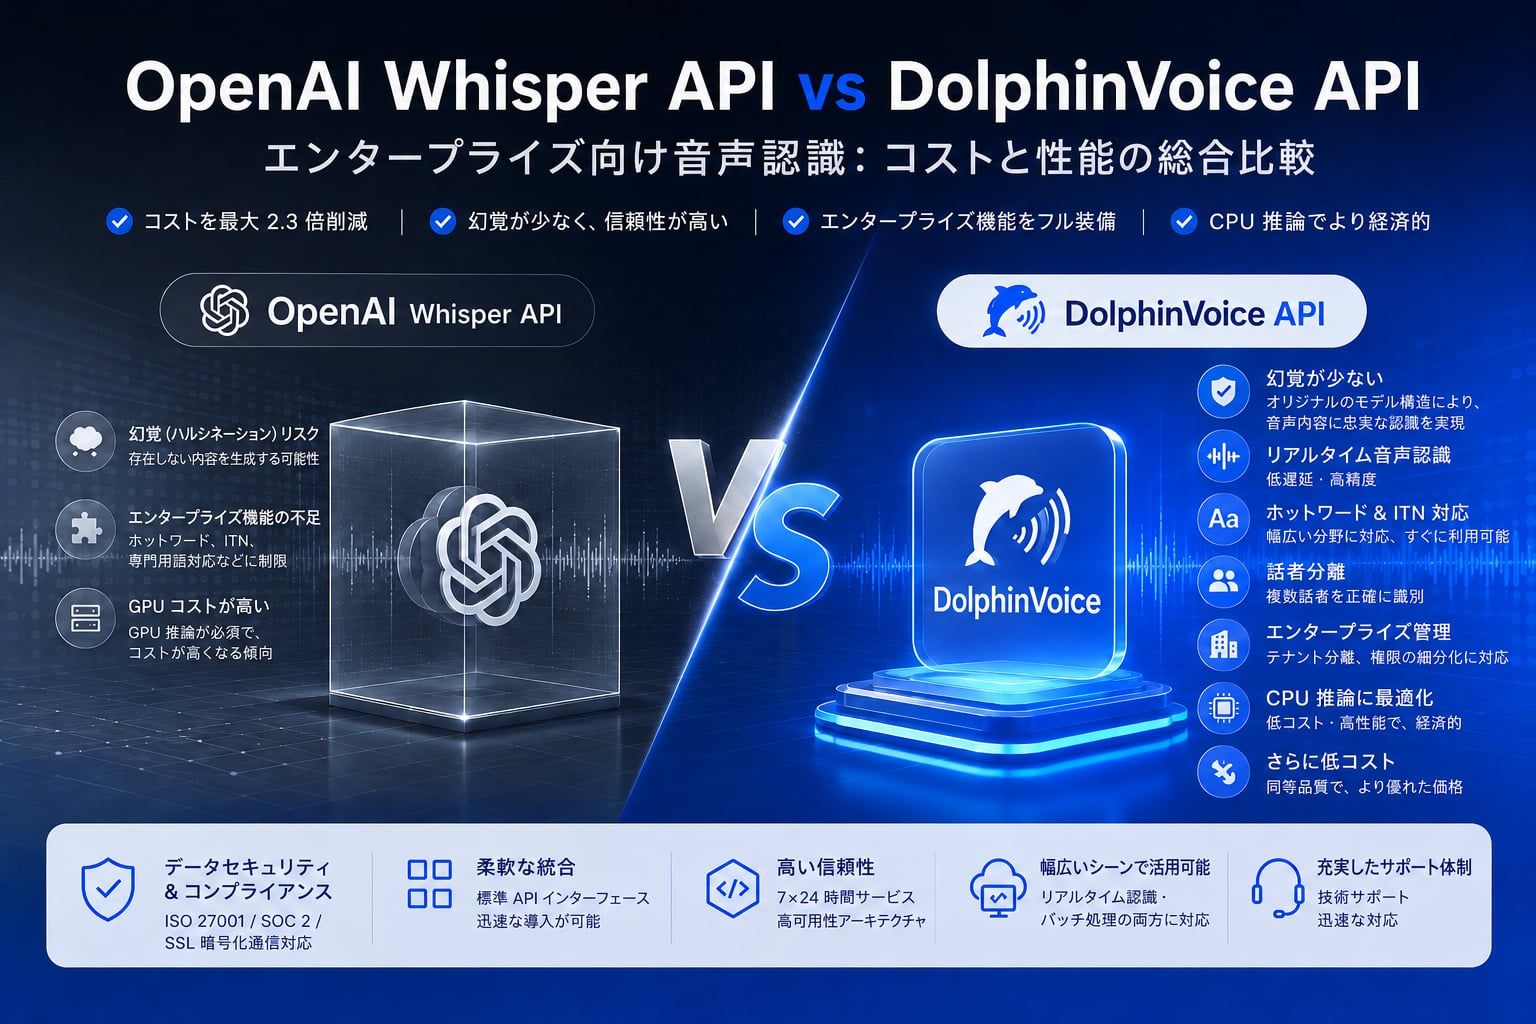
OpenAI Whisper API vs DolphinVoice API:エンタープライズ向け音声認識のコストと機能を徹底比較
OpenAI Whisper API と DolphinVoice API を、アーキテクチャ、リアルタイム・オフラインAPI料金、全込み TCO、ホットワード、話者区別、テキスト後処理、商用規模での検証まで比較します。